Writing Maintainable Code
August 16, 2023 · 15 min read
If you have any questions, feel free to comment below. Click the block can copy the code.
And if you think it's helpful to you, just click on the ads which can support this site. Thanks!
from typing import Callable, Tuple, List
from pandas import DataFrame
项目结构定好了,就开始着手写代码了;那编写代码有哪些注意点呢?
类型提示 #
虽然python是动态类型语言, 变量的类型是可以变的
a = 1.0 # a此时是float
a = 'abc' # a此时是str
但是我们依然可以给变量添加类型提示
a: int = 1 # 提示变量是整数
为什么使用类型提示 #
动态语言的特点就是省略了编程者规定变量类型的过程,为什么还要费力写类型提示呢?
- 复杂函数的代码难以理解,类型提示帮助理解代码
# 以上一期data_pipeline.py中的process_data为例

# 下面函数的逻辑相对复杂,很难快速理解其功能,但是注意到输入的参数和输出都是一个 DataFrame,我们有理由推断这个函数有可能是用于处理数据的。
def process_data(data: DataFrame) -> DataFrame:
    '''
    模拟对数据处理流程中的某个处理步骤,实际情况会复杂很多
    '''

    # 所需的字段
    needed_col = {'id', 'time', 'flag', 'value_1', 'value_2'}

    # 检查处理所需的数据是否存在
    col_names = data.columns.to_list()
    missed_cols = needed_col.difference(col_names) # 查看缺失哪些字段
    if missed_cols:
        raise Exception(f'缺失字段{missed_cols}')

    # 模拟数据处理,实际情况会复杂得多
    days_gap = 30
    end_time = datetime.now()
    start_time = end_time - timedelta(days=days_gap)
    time_filter = data['time'].dt.between_time(start_time, end_time)
    data = data[time_filter]

    data['value_2'] = data['value_2'].map(lambda x: round(pow(x, 3), 5))
    data['value_3'] = data['value_2'] * data['value_1']

    return data[list(needed_col)]
- 有变量类型,减少变量类型造成的 bug
我们用同一份代码,来展示类型提示如何避免 bug 的产生
# 不写提示

def func_1(): # 返回的是一个tuple
	... # 复杂的逻辑,难以看出返回的是什么数据类型


def func_2(): # 返回的是一个list
	... # 复杂的逻辑

a  = 5 # a的取值会变动,例如是对某个滑动时间窗口的值的计算;测试是数据是5,所以func_1没有被调用
if a < 1:
    b = func_1() # 隔一段时间复用func_1的时候已经忘记返回的是什么数据类型了;错哦的认为是返回的list
else:
	b = func_2()

# b.append(10) # 由于变量b在测试时一直是func_2返回的,所以bug没有被发现;结果实际跑起来a<1,触发bug
用文字描述上述代码是如何产生 bug 的,首先我们看下代码流程:
- 我们定义了两个函数,
func_1,func_2;函数逻辑复杂,无法快速识别什么数据类型,而实际上func_1返回的是一个tuple,而func_2返回的是list;
当项目复杂/代码编写时间过久/代码复用时,即使是编码者本人也会遗忘代码的功能和返回类型 - 然后对变量
a赋值,a的取值会变动,例如是对某个滑动时间窗口的值的计算,测试时值为5 - 对a进行判断,如果a<1,就将
func_1返回的值给b,反之就用func_2; - 然后对
b调用了一个append方法;
bug会产生在最后一步,起因在第三步,而根本原因在于func_1,func_2返回的数据类型是不同的:
- 由于测试时
a的值为5,代码调用了func_2,func_1没有被调用; func_2返回的是一个list,具有append方法,bug在测试的时候没有触发- 实际运行的时候,
a的取值有可能小于1,调用func_1返回了tuple,是没有append方法的,由此触发了bug - 根本原因在于,因为项目复杂/代码编写时间过久/代码复用时,错误判断了
func_1,func_2返回的数据类型
而有了类型提示:
# 写提示
def func_1() -> tuple: # 返回的是一个tuple,直接写明
	# 复杂的逻辑
	...

def func_2() -> list: # 返回的是一个list
	... # 复杂的逻辑

a: int  = 5 # 测试用的数据里a是5,所以func_1没有被调用
if a < 1:
    b = func_1() # 由于写明了func_1返回的数据类型,编写代码到这一步时就能发现问题
else:
	b = func_2()
可以看到无论隔了多久、项目多复杂,复用 func_1,一眼就能识别其返回的不是 list,调用 append 是要报错的
当然这个案例还是比较简单,我们不太容易犯这样的错;但实际编程中情况复杂的多,在复杂的场景下,就容易出现动态类型引起的bug。
最后还是要强调,类型提示不具有强制性,类型不同不会引起报错
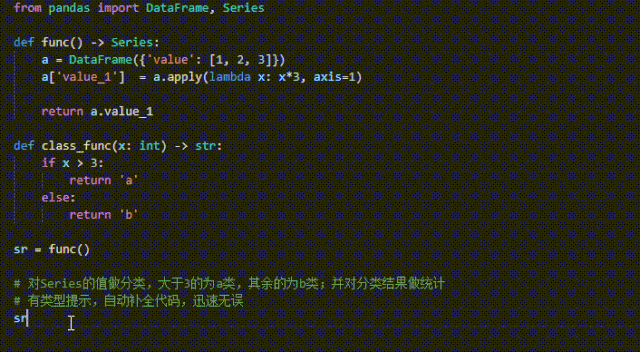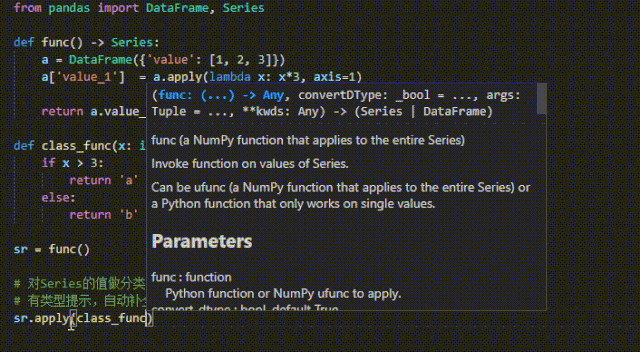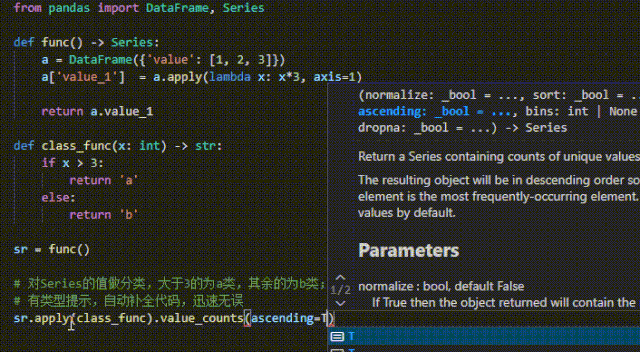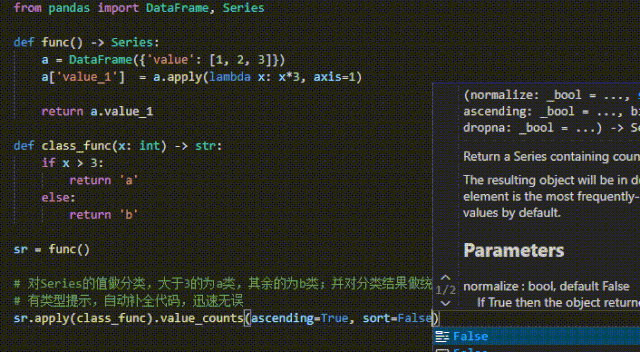
- IDE 可以根据类型进行代码补全,提高编程效率
没有类型提示:需要手动调用方法,如果对 api 不熟悉还有写错的风险
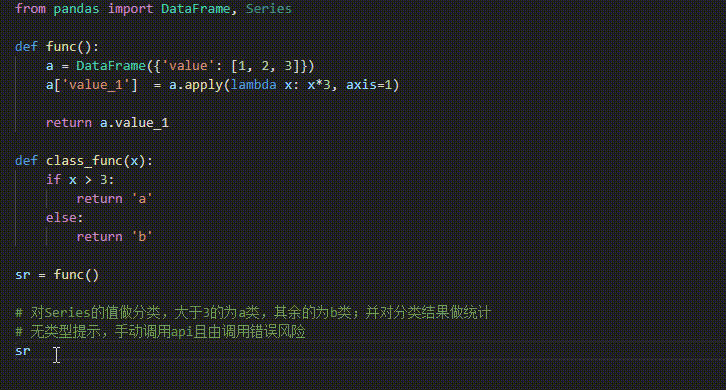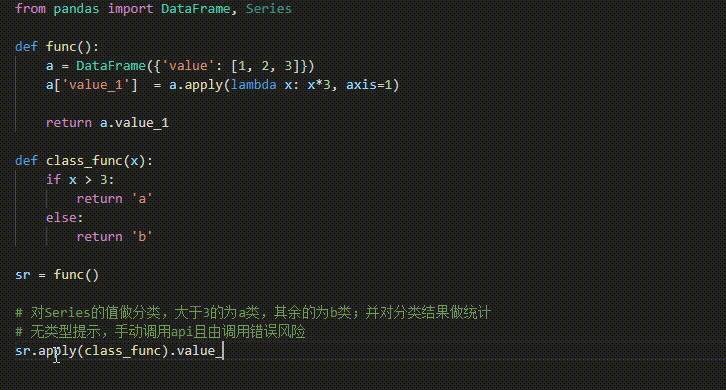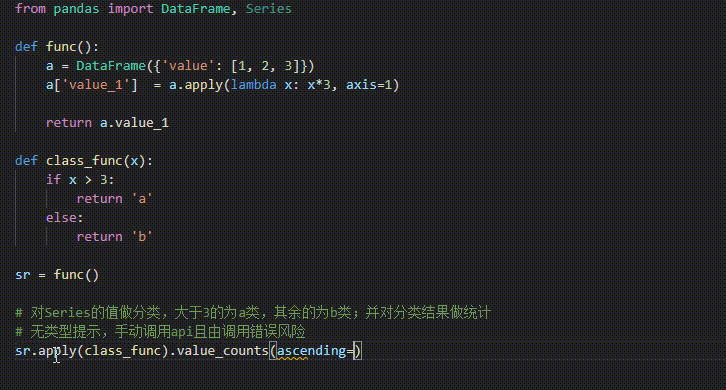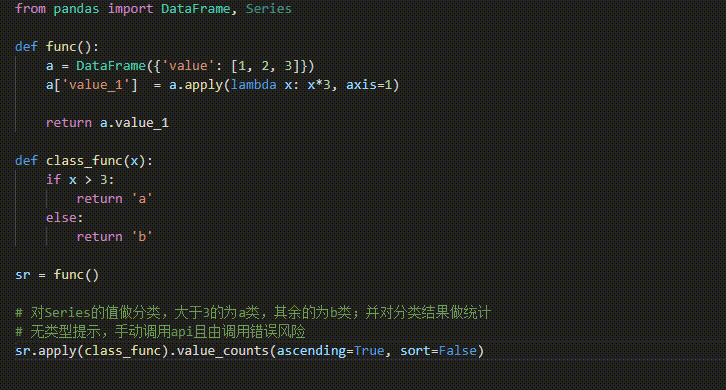
有类类型提示:有代码补全后,提高了编程效率的同时,还能保证正确地调用api
类型提示方法 #
总的来说是用类(class)作为类型提示对象,例如赋值的时候a: int = 1
被标注的对象是标注类的实例,对应上述的例子就是a是int类的实例
注意 int 是一个类,只是可以像函数一样被调用
被用于作类型标注的类具体上分为三种:
- 内置类:
str,list,tuple,… (其余 python 内置的类) - 自定义类/第三方库类
- 使用
typing库,进行更详细的数据提示
# 内置类
def func(x: int) -> str:

    return str(x)

func(2)


# 自定义类

class A:

    def __init__(self, a):
        self.a: int = a

    def func(self, x: 'A'): # 解决循环依赖问题,加入引号
        ...

def func(x: A) -> int:
    return x.a

a = A(2)
func(a)


# typing

def func(x: Tuple[int, str]) -> List[str]: # 不但要知道输入的是tuple,还要知道tuple里面的数据类型是什么
    num = x[0]
    element = x[1]

    return [element]*num

func(x=(2, 'a'))
熟悉内置库/常用库的 api #
内置库 #
除去os, time等常用内置库外,以下库值得注意
- functools
提供一些高阶操作函数例如reduce,partial - itertools
操作迭代对象的函数/类例如chain,combinations - collection
提供额外的数据结构例如deque,defaultdict
常用库 #
numpy, pandas,… (各自领域内常用的库)
如果不熟悉api,就会这样….
# 一个pandas的例子
# 代码只有一个目的,试图获取DataFrame字符串列str_col的小写形式

df_1 = DataFrame(data={'str_col': ['Afas', 'FAD', 'ASSFsF', 'ASSFsF']})

# 原代码
# 速度慢,可读性低,不易维护(而且十分丑陋)
df_2 = DataFrame(data=df_1['str_col'].drop_duplicates().values, columns=['str_col_lower'])
df_2['str_col'] = df_1['str_col'].drop_duplicates().values

for item in range(0, df_2.shape[0]):
    iteml = str(df_2['str_col'][item]).lower()
    df_2['str_col_lower'][item] = iteml

df_1 = df_1.merge(df_2, on='str_col', how='inner')
df_1 = df_1.drop(['str_col'], axis=1)

# 使用pandas的api
# 高效,易读,易维护
df_1['str_col'] = df_1['str_col'].str.lower()
同样的,库的 api 是很零碎的;建议先过一下库的文档留个印象,在实践中慢慢熟悉。
代码规范 #
什么是代码规范
是一种代码风格,包括了空格、换行、缩进的使用,注释的使用,变量命名规范等
有哪些代码规范
pep8, google, yapf, facebook, …(其余企业内部指定的代码规范)
缩进 #
- 每一级缩进使用4个空格(许多编辑器默认tab就是四个空格)
- 续行时包裹的元素,要么使用圆括号、方括号和花括号内的隐式行连接来垂直对齐,要么使用挂行缩进对齐 (续行指的是函数调用的括号、list、tuple这些一行写不下换行的操作)
- 当存在多个元素缩进时,可以更改缩进程度来于其他行进行区分
# 用更多的缩进来与其他行区分
def long_function_name(
        var_one, var_two, var_three,
        var_four): # 参数的缩进
    print(var_one) # 函数内部逻辑缩进


# 与左括号对齐
foo = long_function_name(var_one, var_two,
                        var_three, var_four)


# 挂行缩进应该再换一行, 个人习惯使用挂行缩进
foo = long_function_name(
    var_one, var_two,
    var_three, var_four)
行的最大长度 #
- 所有行限制的最大字符数为79。
- 没有结构化限制的大块文本(文档字符或者注释),每行的最大字符数限制在72
# 代码过长,通过反引号进行换行
df_1.merge(df_2, left_on='left_key', right_on='right_key', how='outer').\
    groupby(by=['group_key_1', 'group_key_2'], as_index=False, sort=False).\
    drop_duplicates(subset=['col_1', 'col_2'], keep='first').apply(func, func_arg_1=2 ,axis=1)
注释 #
注释遵循以下原则:最好是描述为什么, 而不是翻译代码做了什么; 除非这一段代码比较难懂。
空格 #
- 右括号前不要加空格
'''符合约定的代码'''
func(var[1], {'key': 2})

'''不符合约定的代码'''
func( var[ 1 ], { 'key': 2 } )
- 逗号,冒号 左边不加空格右边加空格
'''符合约定的代码'''
y: int = 3
if x == 4:
    print(x, y)

'''不符合约定的代码'''
y : int = 3
if x == 4:
    print(x, y)
操作符左右各加一个空格,不要为了对齐增加空格
函数默认参数使用的赋值符左右省略空格, 但如果有类型提示则使用空格
''' 符合约定的代码 '''
def func(var_0, var_1=0.0, var_3: int = 1):
    return magic(r=real, i=imag)

''' 不符合约定的代码 '''
def func(var_0, var_1 = 0.0, var_3:int=1):
    return magic(r = real, i = imag)
命名规范 #
给对象命名
- 函数/类里的方法尽量用动词
'''推荐'''
def get_data():
    ...

'''不推荐'''
def data_getting():
    ...
- 类,变量,参数尽量用名词
- 文件命不要和内置module重名;变量不要和内置变量重名
# 不推荐,因为和内置类重名
def str():
    ...
- 类名用驼峰(单词间没有下划线,首字母大写), 函数和变量用下划线
class DataSource:

    def get_data_from_db(self):
        raw_data = ...

def func_with_long_name(x):
    ...
代码规范也有自动化的工具例如 autopep8 等。
References
Related readings
- Building a Project Structure
- Overview of the AI Development Software Environment
- Image Classification and Foundational Vision Models
If you want to follow my updates, or have a coffee chat with me, feel free to connect with me: