Building a Project Structure
August 15, 2023 · 9 min read
If you have any questions, feel free to comment below. Click the block can copy the code.
And if you think it's helpful to you, just click on the ads which can support this site. Thanks!
在具体的数据科学场景下,按照项目结构→代码编写→功能划分→组织代码的顺序,组织高质量的代码。
项目结构也可认为是目录结构,例如
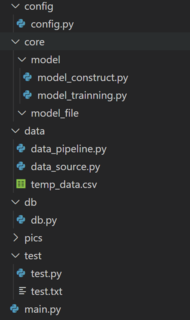 Image Name
我们将项目代码拆分成多个功能模块,固化成函数/类并写到不同的文件中,存放在不同的路径里,python 将每个 py 文件视作为一个模块,可以用 import 调用;例如在 main.py 里调用 /db/db.py 里的函数 create_conn
from db.db import create_conn
conn = create_conn() # create_conn创建了一个数据库的链接对象
为什么要项目结构 #
我们先从一个简单数据计算的场景开始,流程为:
- 从各种数据源获取数据 (多个数据库、文件等)
- 数据处理
- 储存
没有项目结构的代码会是将所有功能放到同一个文件,存在以下缺点: - 变量名有复用现象可能造成 bug (例如 sql, col_names)
- 代码会变的冗长,难以识别整体代码流程和功能,对比
main.py中清晰的代码流程尤为明显; - 函数的定义和调用混在一起,变量/函数的引用关系变得极其复杂
而通过构建项目结构,合理的拆分功能模块是很有必要的,首先构建如下项目结构:
└── root # 根目录
    ├─ data_pipeline.py #  数据处理的实际流程;如用notebook编程则是data_pipeline.ipynb
	├─ data_source.py # 从各种数据源获取数据,整理成通用的数据格式
	├─ data_save.py # 数据储存
	├─ db.py # 与数据库进行交互的代码
	├─ utils.py # 通用的函数,有可能被各文件引用;例如数据结构转化
    └─ main.py # 主文件,调用所有函数/功能,执行代码流程
- 根据项目结构可以知道代码分为几个模块 (module),让我们更有目的性的阅读源码;例如
data_pipeline.py从文件名就知道该文件内的代码都和数据清洗有关,data_source.py就是从不同的源头获取数据的。 - 方便定位代码,提升维护性
- 项目结构划分各个功能模块的职责和边界,使其各自发展互不干扰
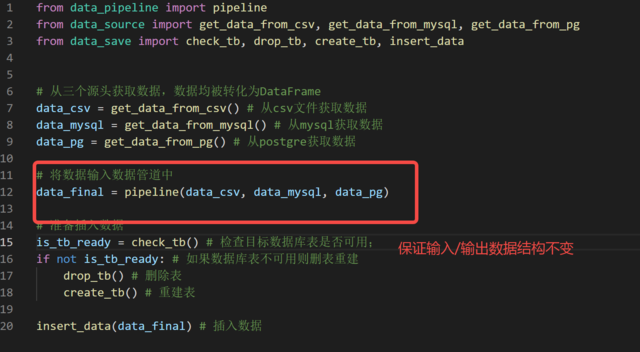
例如数据清洗流程经常需要修改,划分了结构后只需保证
data_pipeline.pipline函数的输入/输出数据格式不变,无论怎么修改清洗流程,其余所有代码都不用变动
- 模块根据功能集成了多种方法,这可以方便的复用代码成果,形成个人代码库
- 明确功能/函数之间的引用关系,减少出现
修改一个函数,带崩一大片的情况,变量/函数之间往往有复杂的引用关系;而构建项目结构后,引用关系会在import部分给出提示。
怎样构造项目结构 #
python 没有固定的项目结构规范,因为 python 将每一个文件视作为一个模块(module),可以自由导入。下面可以作为一些参考:
简单数据计算 #
└── data_cal # 根目录
    ├─ data_process/* # 获取/处理数据的逻辑放在这里
    ├─ data_cache/* # 临时数据文件/处理好的数据放在这里
    ├─ db/* # 与数据库交互的代码
    ├─ main.py # 启动文件,调用以上所有功能性代码,专注于数据处理流程编写;用notebook编程可以是main.ipynb
    └─ requirements.txt # 注明项目运行需要哪些库
传统机器学习项目 #
└──ml_project # 根目录
    ├── config/* # 配置文件
    ├── data/* # 与数据有关的代码都放在这里
    │   ├── data_pipeline/* # 对数据处理的代码
    │   ├── feat_construct/* # 对处理好的数据构造特征
    ├── data_cache/* # 处理好的数据/临时的数据文件放在这个路径下
    ├── db/* # 数据库交互逻辑
    ├── log/* # 存放日志以及定义logger类
    ├── model/* # 与模型有关的代码
    │   ├── model_construct/* # 构建模型类的代码,如果使用已有框架例如sklearn,可以考虑和model_train文件合并
    │   ├── model_serve/* # 使用模型进行预测,并对结果储存至数据库;另附有对目标数据库表检测及建表的逻辑
    │   ├── model_train/* # 对模型进行训练,并按要求储存模型文件,删除过期的模型文件;视情况可以和model_constuce文件合并
    ├── utils/* # 通用的功能性代码,例如将一个list转化为多个特定的数据结构;utils里的函数有可能会被各种代码文件调用
    ├── main.py # 对所有函数/功能进行调用的主文件
    └── requirements.txt # 注明项目运行需要哪些库
深度学习项目 #
└── dl_project # 根目录
    ├─ checkpoints/* # 存放模型训练的checkpoints和计算图文件
    ├─ data_pipeline/* # 获取/处理数据的逻辑放在这里
    ├─ data_cache/* # 临时数据文件/处理好的数据放在这里
    ├─ model/* # 构建模型类/存放历史版本的模型文件
    ├─ db/* # 与数据库交互的代码
    ├─ config/* # 配置文件;例如模型超参,数据存放路径
    ├─ embedding/* # 训练得到的embedding
    ├─ test/* # 测试用例
    ├─ main.py # 启动文件,调用以上所有功能性代码,专注于项目流程逻辑编写
    └─ requirements.txt # 注明项目运行需要哪些库
部署模型接口 #
└──ml_api # 根目录
    ├── api/* # 构造web接口,将定义方法挂载在相应的router上
    ├── config/* # 配置文件
    ├── core/* # 各接口核心的逻辑代码
    │   ├── api_one_method/* # 第一个接口的逻辑
    │   ├── api_two_method/* # 第二个接口的逻辑
    │   ├── middlerware.py # 中间件
    │   ├── router.py # 构造路由
    ├── db/* # 数据库交互逻辑
    ├── template/* # 一些模板文件
    ├── log/* # 存放日志以及定义logger类
    ├── utils/* # 通用的功能性代码
    ├── requirements.txt # 注明项目运行需要哪些库
    ├── server.py # 接口服务部署
    └── start.sh # 开启服务的脚本文件,包括启用环境等命令
Related readings
- Overview of the AI Development Software Environment
- Image Classification and Foundational Vision Models
If you want to follow my updates, or have a coffee chat with me, feel free to connect with me: