Building a RAG Chatbot with NVIDIA AI Endpoints
August 18, 2024 · 20 min read
If you have any questions, feel free to comment below. Click the block can copy the code.
And if you think it's helpful to you, just click on the ads which can support this site. Thanks!
基于 NVIDIA AI Endpoint、LangChain 和 FAISS 构建 RAG 智能对话机器人,实践商品问答与检索增强生成。
NVIDIA AI-AGENT #
- 项目名称:AI-AGENT夏季训练营 — RAG智能对话机器人
- 报告日期:2024年8月18日
- 项目负责人:timerring
项目概述 #
本项目旨在开发一款基于 SLM 的经过 RAG(Retrieval-Augmented Generation)改进的智能对话机器人。该机器人将集成先进 phi-3-small-128k-instruct 语言模型,以提供高效、准确的商品咨询服务。
应用场景与亮点 #
应用场景:
- 在线客服:机器人作为在线商店的虚拟客服,提供商品信息查询、购买咨询、订单处理等服务。
- 互动:与潜在客户进行互动,解答商品相关问题,引导购买。
亮点:
- 高性能SLM模型:选择的
phi-3-small-128k-instruct模型,结合了较小体积与快速处理速度,适合在资源受限的环境中部署。 - RAG技术应用:利用RAG模型架构,通过检索外部知识库增强回答的准确性和可靠性,提供深入、有价值的答案。
- 实时知识更新:RAG模型支持检索库的即时更新,确保提供与最新信息相关的回答,无需重新训练模型。
- 高度定制化:根据不同垂直领域的需求,定制化RAG模型,快速适应特定商品或服务的咨询需求。
- 降低成本:减少对模型重新训练的需求,降低训练成本,提高经济性。
通过结合 SLM 和 RAG,本项目将提供一个高效、智能、且用户友好的商品对话销售解决方案,旨在提升客户体验,降低企业运营成本,并提高销售转化率。
技术方案与实施步骤 #
模型选择 #
项目采用 phi-3-small-128 k-instruct 的 SLM,因为该模型具有较小的体积和较快的处理速度,同时128k 的指令微调确保了模型对任务的适应性。并且选择轻量化的大模型 SLM,方便部署在移动端,嵌入式开发板上面。并且通过 RAG 利用外部知识源来增强大语言模型的生成能力。
传统的大模型存在以下的短板:
- 大模型会有自己的知识局限性
- 用户有结合自己数据微调大模型的需求
- 由于过拟合或者模型泛化能力不足,大模型会出现“幻觉”。
RAG(Retrieval-Augmented Generation)模型结合了信息检索和文本生成优势的模型架构,它通过利用外部知识源来增强大语言模型的生成能力。它的优势有以下几点:
- 外部知识的利用:RAG模型能够有效地利用外部知识库,引用大量信息来提供更深入、准确且有价值的答案,提高生成文本的可靠性。
- 数据更新及时性:RAG模型具备检索库的更新机制,可以实现知识的即时更新,无需重新训练模型,从而提供与最新信息相关的回答。
- 回复具有解释性:由于RAG模型的答案直接来自检索库,其回复具有很强的可解释性,用户可以核实答案的准确性,从信息来源中获取支持。
- 高度定制能力:RAG模型可以根据特定领域的知识库和prompt进行定制,使其快速具备该领域的能力,适用于各种垂直领域的应用。
- 减少训练成本:RAG 模型在数据上具有很强的可拓展性,可以将大量数据直接更新到知识库,以实现模型的知识更新,这一过程不需要重新训练模型,更加经济实惠。
- 通用性:RAG模型是通用的,可以用于多种任务,相对于微调模型,RAG提供了一种更为灵活的解决方案。
数据的构建 #
数据构建过程 #
数据构建过程包括从特定目录读取文本文件,清洗数据,并为向量化处理准备数据:
- 数据读取:从
./zh_data/目录读取所有.txt文件。 - 数据清洗:移除空行,并确保每个数据项至少包含一个字符。
- 元数据记录:记录每个文本片段的来源文件。
向量化处理方法 #
向量化处理包括以下步骤:
- 文本分割:使用
CharacterTextSplitter将文本分割成较小的块,以便于处理。 - 向量存储创建:使用
FAISS创建向量存储,这是一种高效的相似性搜索库。 - 嵌入生成:使用
NVIDIAEmbeddings生成文本的嵌入向量。
向量化处理的优势 #
- 高效检索:FAISS库提供了快速的向量搜索能力,有助于在大规模数据集中检索相似项。
- 节省内存:FAISS优化了内存使用,使得处理大型数据集成为可能。
实施步骤 #
环境搭建 #
开发的硬件环境是基于 Jetson NX 实现的,采用 JupyterLab 进行连接开发。首先创建 python 3.8 虚拟环境:
conda create name ai endpoint python=3.8
# 进入虚拟环境
conda activate ai endpoint
然后安装 nvidia ai endpoint 工具
pip install langchain-nvidia-ai-endpoints
然后安装 Jupyter Lab
pip install jupyterlab
安装 langchain_core
pip install langchain core
安装 langchain
pip install langchain
安装 matplotlib
pip install matplotlib
安装 falss,这里如果没有 GPU 可以安装 CPU 版本
pip install faiss-cpu-1.7.2
安装 OPENAI 库
pip install openai
在搭建完开发环境之后,可以申请模型对应的 api_key,这里选择 llama-3_1-405 b-instruct[1] 模型的 api。
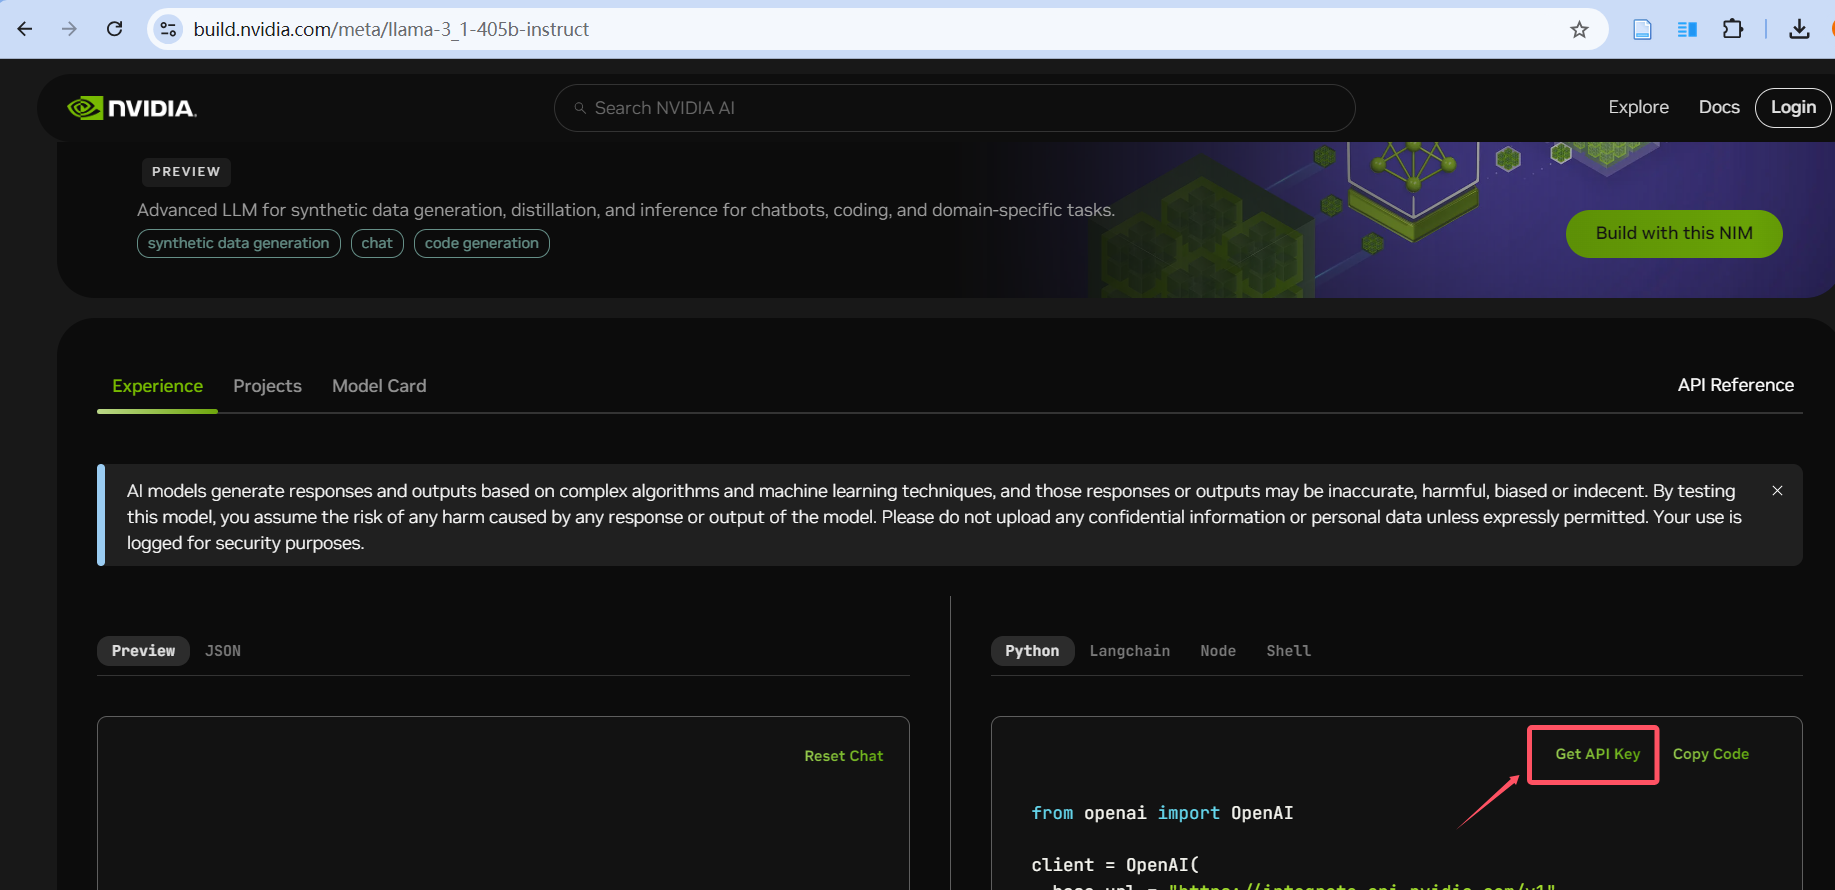
搭建好环境之后可以测试 api 是否可用,这里的 your api_key 替换为刚刚申请的 api_key,
from openai import OpenAI

client = OpenAI(
  base_url = "https://integrate.api.nvidia.com/v1",
  api_key = "your api_key"
)

completion = client.chat.completions.create(
  model="meta/llama-3.1-405b-instruct",
  messages=[{"role":"user","content":"iphone4有几个系列?"}],
  temperature=0.2,
  top_p=0.7,
  max_tokens=1024,
  stream=True
)

for chunk in completion:
  if chunk.choices[0].delta.content is not None:
    print(chunk.choices[0].delta.content, end="")
完成之后结果如下:
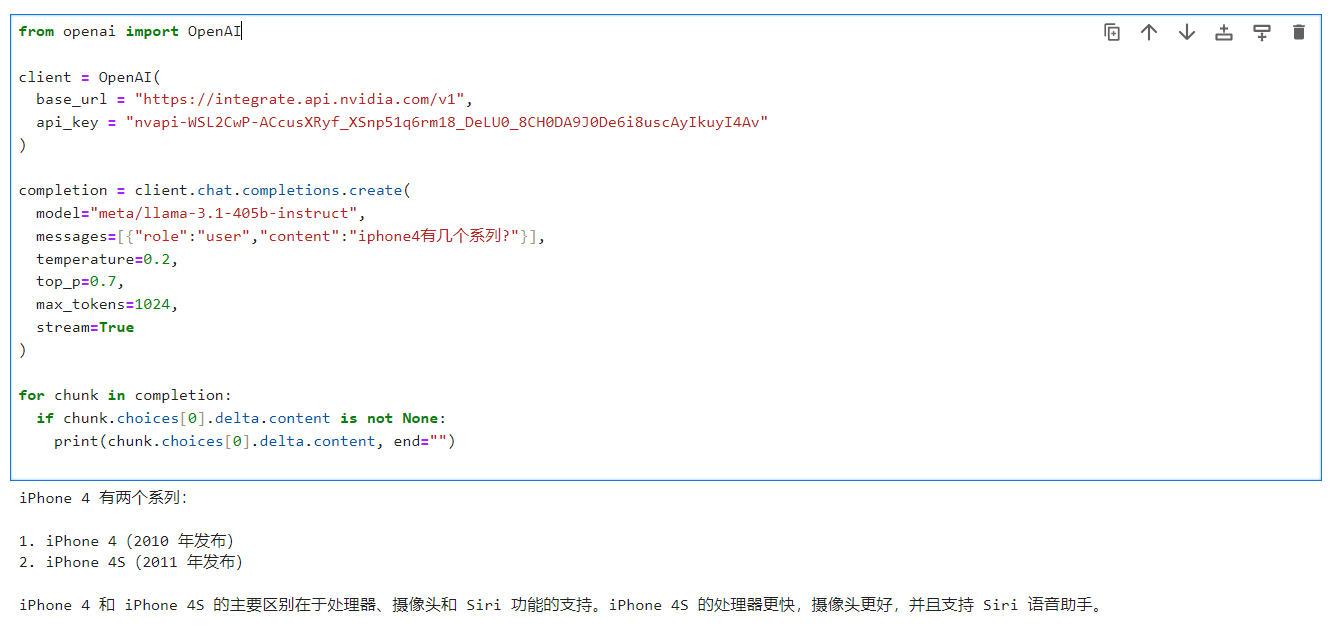
在验证完 api 可用之后,可以开始接下来的实现了。
代码实现 #
Step 1 - 使用 NVIDIA_API_KEY #
在现式调用完 api_key 之后,开发环境中为防止密钥泄漏,采用以下方式检查和设置环境变量 NVIDIA_API_KEY,用于验证 NVIDIA API 的密钥。
import getpass
import os

if os.environ.get("NVIDIA_API_KEY", "").startswith("nvapi-"):
    print("Valid NVIDIA_API_KEY already in environment. Delete to reset")
else:
    nvapi_key = getpass.getpass("NVAPI Key (starts with nvapi-): ")
    assert nvapi_key.startswith("nvapi-"), f"{nvapi_key[:5]}... is not a valid key"
    os.environ["NVIDIA_API_KEY"] = nvapi_key
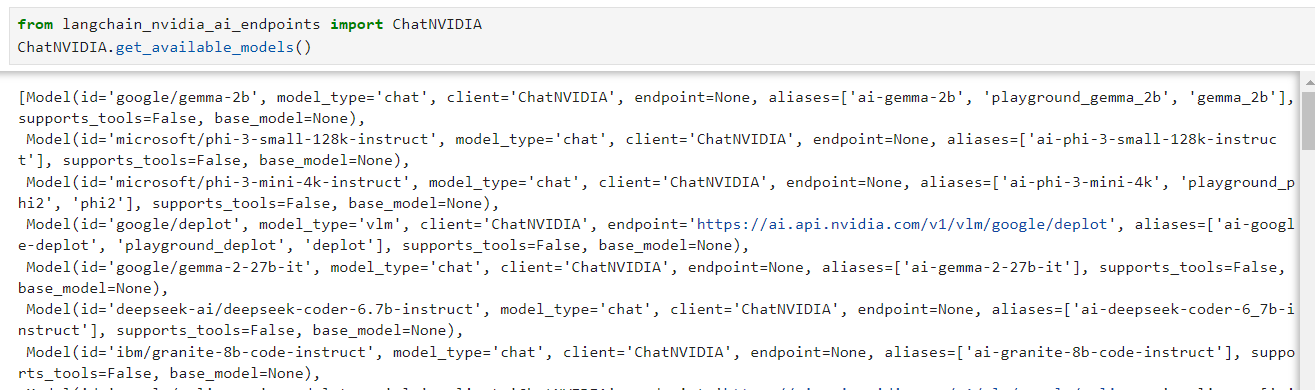
然后调用ChatNVIDIA类中的get_available_models方法查看一下有哪些模型可以使用:
from langchain_nvidia_ai_endpoints import ChatNVIDIA
ChatNVIDIA.get_available_models()
返回是含有多个模型的列表:
Step 2 - 初始化 SLM #
SLM更适合特定的任务,适合在资源受限的环境中运行。这里使用的小模型是 phi-3-small-128 k-instruct。
llm = ChatNVIDIA(model="ai-phi-3-small-128k-instruct", nvidia_api_key=nvapi_key, max_tokens=512)
result = llm.invoke("iphone4有几个系列?")
print(result.content)
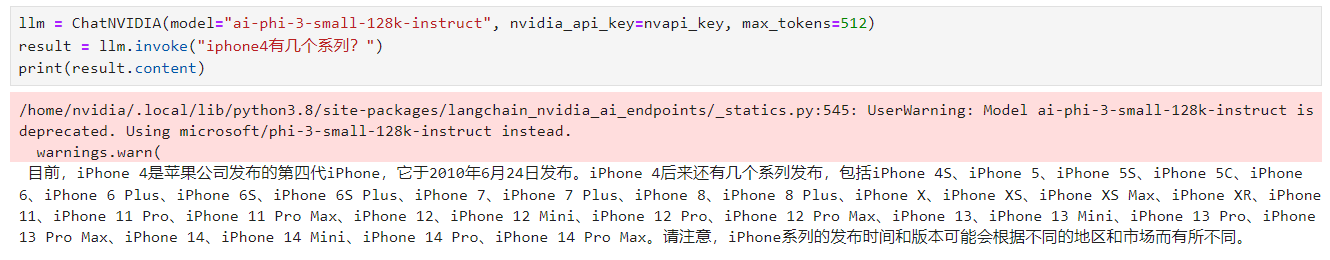
针对生成的结果分析可知,SLM 可能存在的问题有:
- 知识更新问题:如果 SLM 的训练数据集没有包含最新的信息或者训练数据集较小,它可能无法准确地反映现实世界的最新知识。
- 泛化能力不足:如果训练数据中缺少类似的实例,那么 SLM 可能在泛化到新的或不常见的情况时表现不佳。
因此,RAG 即"检索增强的生成"是必不可少的。RAG 模型能够通过检索组件获取与问题或任务相关的上下文信息,这有助于模型更好地理解问题并生成更准确的回答。它的工作流程如下:
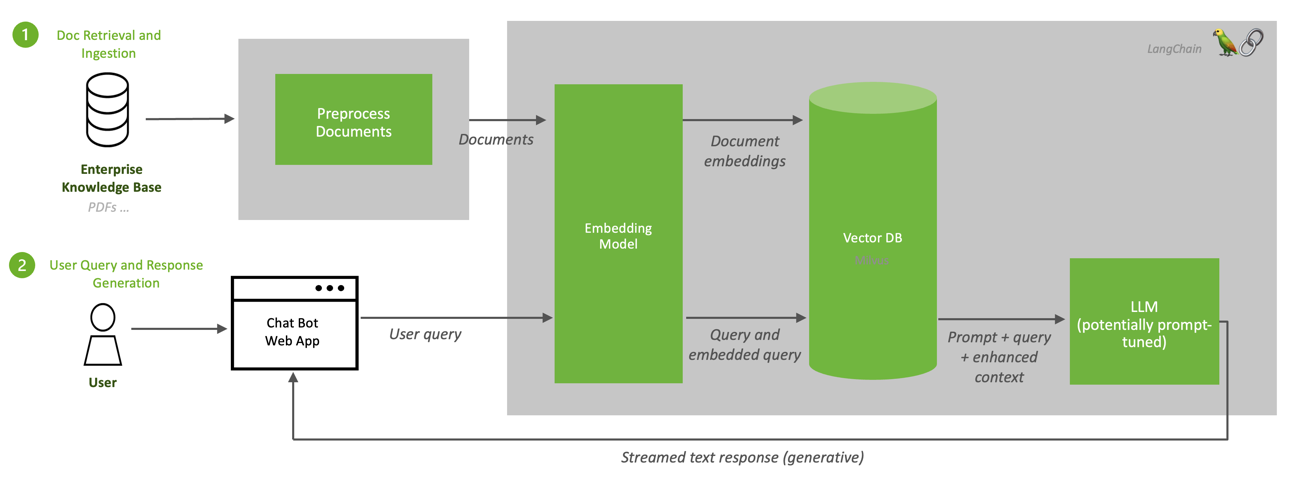 其中,较为关键的是 Embedding Model,它将输入的文档以及用户的查询文本转换为词向量,方便存储在词向量库中方便比对。
测试与调优 #
Step 3 - 初始化 ai-embed-qa-4 向量模型 #
接下来采用 RAG 提升回答的准确度:
from langchain_nvidia_ai_endpoints import NVIDIAEmbeddings
embedder = NVIDIAEmbeddings(model="ai-embed-qa-4")
首先引入 NVIDIAEmbeddings 到 nim 当中,nim 平台当中找到对应的向量化模型。
Step 4 - 获取文本数据集并清洗 #
iPhone 4是苹果公司设计及销售的一款智能手机,是iPhone的第四代。它的前作是iPhone 3GS,iphone4一共有2个系列,有iPhone 4和 iphone 4S。随着一系列重大的信息泄漏事宜,苹果公司于2010年6月7日在旧金山举行的2010年苹果公司开发者大会上发布iPhone 4,并于同年6月24日在美国、英国、法国、德国及日本开售。iPhone 4为iPhone系列引入了崭新的硬件设计,而苹果公司的时任首席执行官史提夫·乔布斯称它为当时世界上最薄的智能手机,它由不锈钢框架组成,内部组件置于硅酸铝玻璃之间。iPhone 4还推出了苹果公司新款高分辨率的Retina显示屏,其像素密度为每英寸326像素,同时保持与其前体相同的尺寸与纵横比。iPhone 4还推出了苹果公司的A4芯片以及iOS 4,它特别引入了多任务功能和苹果公司新的FaceTime通话视频聊天服务。iPhone 4也是第一款包含前置镜头的iPhone,也是第一款以CDMA网络版本发布的iPhone,结束AT&T作为iPhone产品于美国独家运营商的时期。

iPhone 4广泛受到欢迎,评论家赞誉它经改造的设计,与以前的型号相比,有着更强大的硬件。尽管于24小时里接到超过600,000宗预订订单的市场上成功,iPhone 4的发布受到其高度公开报告的困扰,有指其新的天线设计出现异常,导致设备在以某种方式手持的时候,设备将会丢失其蜂窝信号。大多数人接触手机的外缘也会导致信号强度显著下降。
import os
from tqdm import tqdm
from pathlib import Path

# Here we read in the text data and prepare them into vectorstore
ps = os.listdir("./zh_data/")
data = []
sources = []
for p in ps:
    if p.endswith('.txt'):
        path2file="./zh_data/"+p
        with open(path2file,encoding="utf-8") as f:
            lines=f.readlines()
            for line in lines:
                if len(line)>=1:
                    data.append(line)
                    sources.append(path2file)
然后读入额外的 iphone4的相关文本描述,并且进行基本的数据清洗工作,例如从 data 列表中移除所有的空行。
documents=[d for d in data if d != '\n']
len(data), len(documents), data[0]
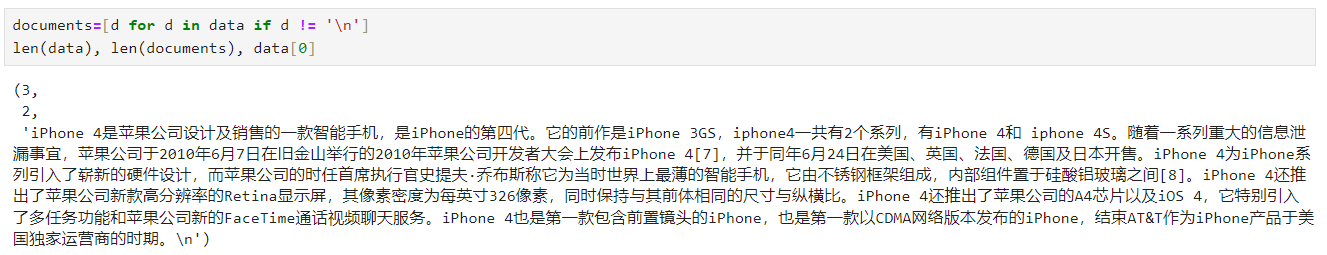
Step 5 - 将文档处理到 faiss vectorstore 并将其保存到磁盘 #
# 使用`langchain`库来创建一个向量存储(vector store)并将其保存到磁盘。
from operator import itemgetter
from langchain.vectorstores import FAISS
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough
from langchain.text_splitter import CharacterTextSplitter
from langchain_nvidia_ai_endpoints import ChatNVIDIA
import faiss
接下来将文档分批的做 embedding ,分批的去做 embedding,储存到向量知识库当中,这里定义的 store 即是向量知识库。
text_splitter = CharacterTextSplitter(chunk_size=400, separator=" ")
docs = []
metadatas = []

for i, d in enumerate(documents):
    splits = text_splitter.split_text(d)
    #print(len(splits))
    docs.extend(splits)
    metadatas.extend([{"source": sources[i]}] * len(splits))

store = FAISS.from_texts(docs, embedder , metadatas=metadatas)
store.save_local('./zh_data/nv_embedding')
注意:
- 这里只需要执行一次,因为这里
save_local,后面可以通过load_local重读已经保存的向量存储。 - 这里的
chunk_size取决于 embedding 模型能接受的 token 数,一般要小于能接受的 token 数,否则信息就会出现遗漏。
Step 6 - 重读之前处理并保存的 Faiss Vectore 存储 #
# Load the vectorestore back.
store = FAISS.load_local("./zh_data/nv_embedding", embedder,allow_dangerous_deserialization=True)
Step 7- 提出问题并基于 phi-3-small-128 k-instruct 模型进行 RAG 检索 #
retriever = store.as_retriever()

prompt = ChatPromptTemplate.from_messages(
    [
        (
            "system",
            "Answer solely based on the following context:\n<Documents>\n{context}\n</Documents>",
        ),
        ("user", "{question}"),
    ]
)

chain = (
    {"context": retriever, "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)

chain.invoke("iphone4有几个系列?")
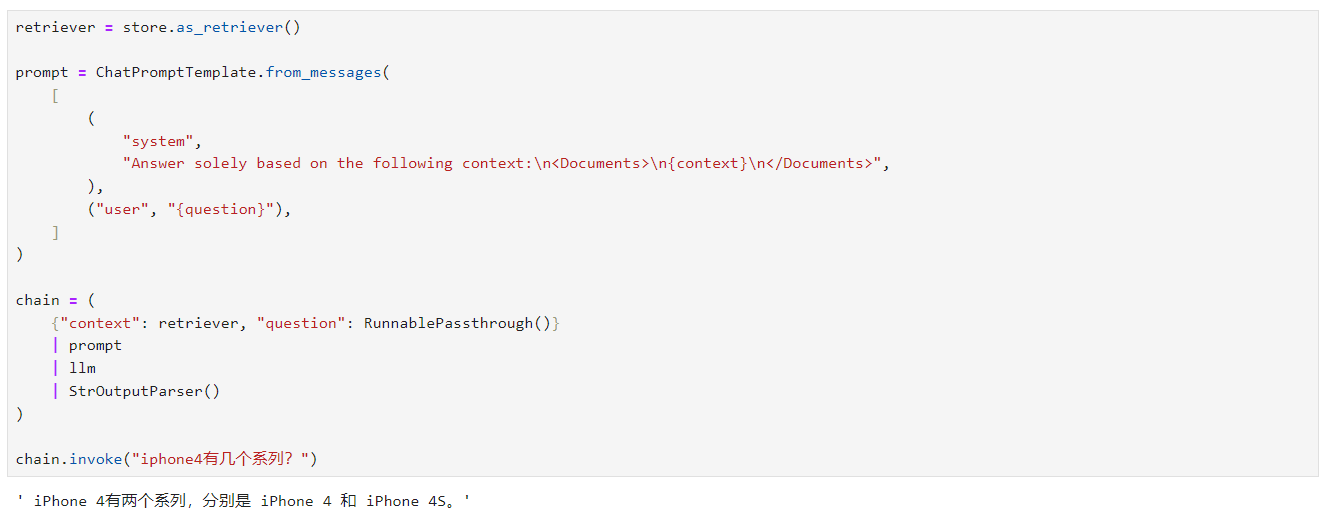
最后,可见通过 RAG 的方式可以提升模型回答问题的精准度。
项目成果与展示 #
应用场景展示 #
该对话机器人可以作为某一具体商品的销售客服,可以做到既能回答广泛的该品类的问题,也能根据经常更新的商品信息回答出用户想要了解的商品细节,能够节约商家的人工成本,同时能为用户提供 7*24 小时的不间断服务。
功能演示 #
如下,根据更新的文本描述可以准确地回答出 iphone4 的相关问题:
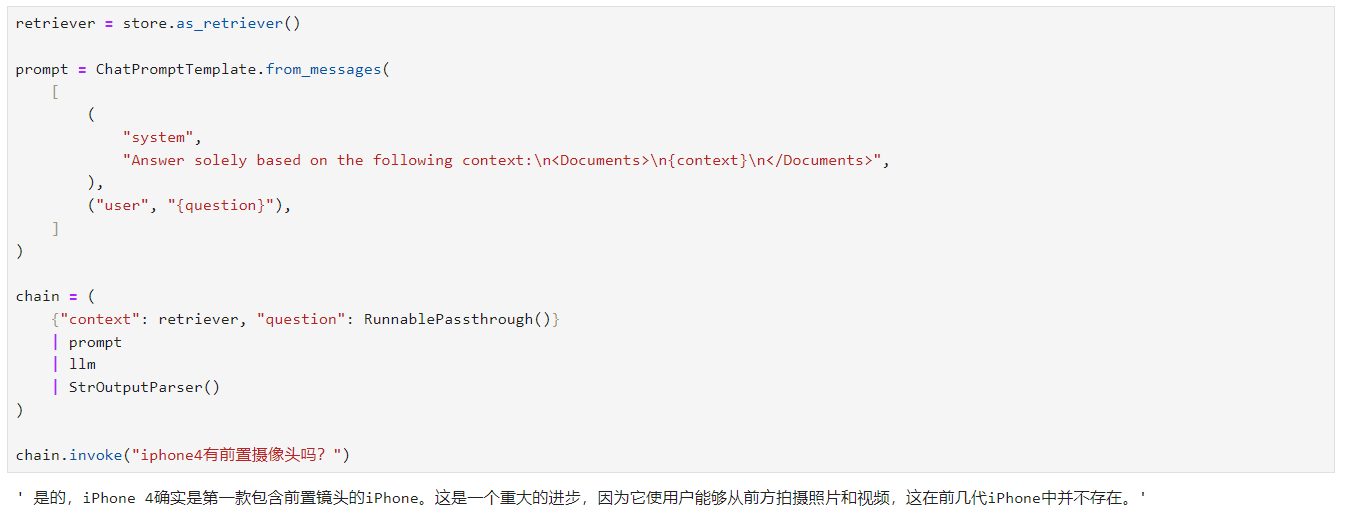
接下来几天还会更新基于 NIM 建构多模态 AI-Agent 应用,敬请期待。再次感谢 NVIDIA 社区提供的优质教程与动手实践机会。
附件与参考资料 #
- NVIDIA AI Endpoint介绍页面: https://python.langchain.com/v0.1/docs/integrations/chat/nvidia_ai_endpoints/[2]
- NVIDIA NIM 页面: https://build.nvidia.com/explore/discover[3]
- NVIDIA DLI 相关学习资料页面:https://www.nvidia.cn/training/online/[4]
- 本文选择的模型: https://build.nvidia.com/meta/llama-3_1-405b-instruct[5]
References
If you want to follow my updates, or have a coffee chat with me, feel free to connect with me: