GPU Hardware Architecture
July 28, 2023 · 11 min read
If you have any questions, feel free to comment below. Click the block can copy the code.
And if you think it's helpful to you, just click on the ads which can support this site. Thanks!
介绍 CPU 与 GPU 的架构差异、GPU 硬件平台、Jetson 设备及 Amdahl 定律。
为什么要学 CUDA? #
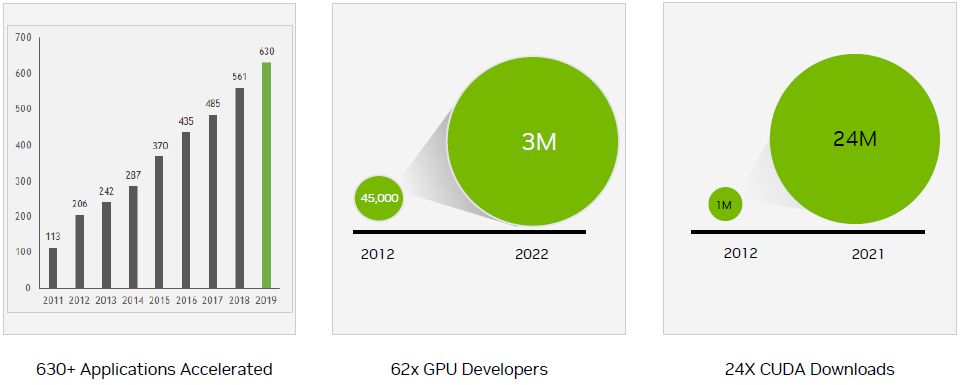
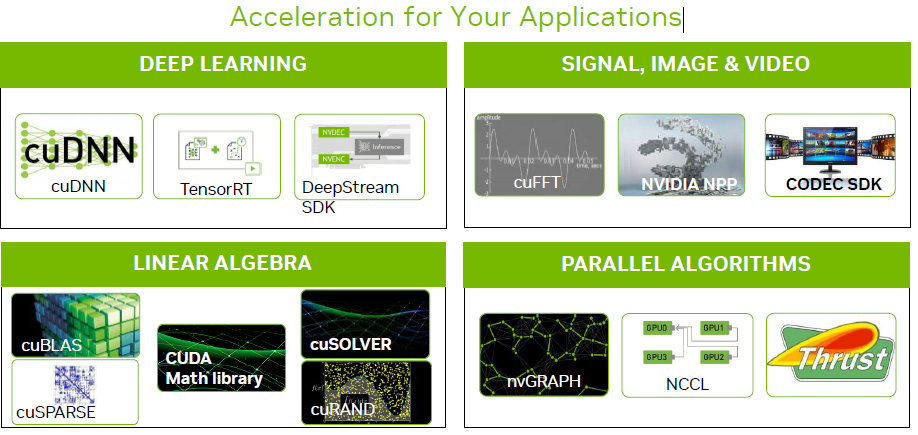
因为英伟达绝大多数加速库除了网络相关这些以外的加速库,基本上都是基于 CUDA 底层这样一个生态基础的,利用 CUDA 去驱动 gpu 发挥效果。
GPU ACCELERATED LIBRARIES #
Acceleration for Your Applications
适合人群 #
- 有志于从事 CUDA/GPU 系统开发的开发者
- 使用 CUDA/GPU 并行计算系统的科研工作者
- 计算机,电子,自动化,生医等相关专业的硕士研究生或高年级本科生
基本能力 #
- 了解和掌握 GPU/CUDA 并行计算系统的分析,设计,开发,调试和优化方法
- GPU 并行计算系统的分析能力,编程能力
- 能够通过看 API 手册之类的,自行进步以从事 GPU 开发职业
基础知识 #
- 计算机体系结构基础
- C 语言程序设计
- 计算机算法基础
- 线性代数
内容参考 #
- CUDA C Programming Guide NVIDIA Corp.
- CUDA Best Practice Guide, NVIDIA Corp.
- CUDA 编程基础与实践樊哲勇著
- https://github.com/brucefan1983/CUDA-Programming[1]
CUDA 并行计算基础 #
说明 #
What is CUDA? #
CUDA:Compute Unified Device Architecture
CUDA C/C++
- 基于 C/C++ 的编程方法
- 支持异构编程的扩展方法
- 简单明了的 APIs ,能够轻松的管理存储系统
CUDA 支持的编程语言:C/C++/Python/Fortran/Java/……
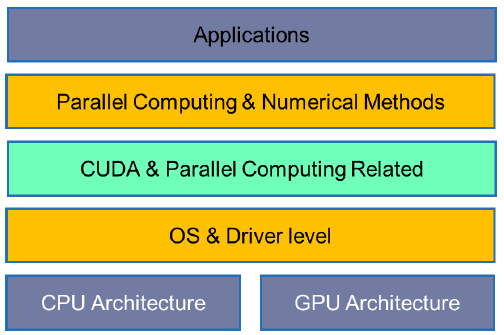
CUDA 它是一个 toolkit,它提供了一些接口,能够通过 driver 去调动底层 CPU 的一个硬件。还能给上层的应用,或者说其他的框架以及接口能够让这些接口不必再通过驱动去比较复杂的方式去调用这个硬件。直接给出一些统一的接口,去调用底层的一些硬件比较灵活,比较方便。例如 Numerical Methods 中常见的是 TF 以及 PyTorch。
CPU 架构 #
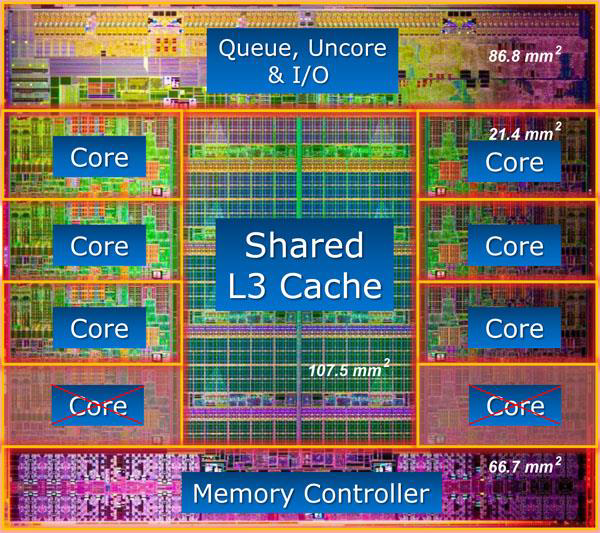
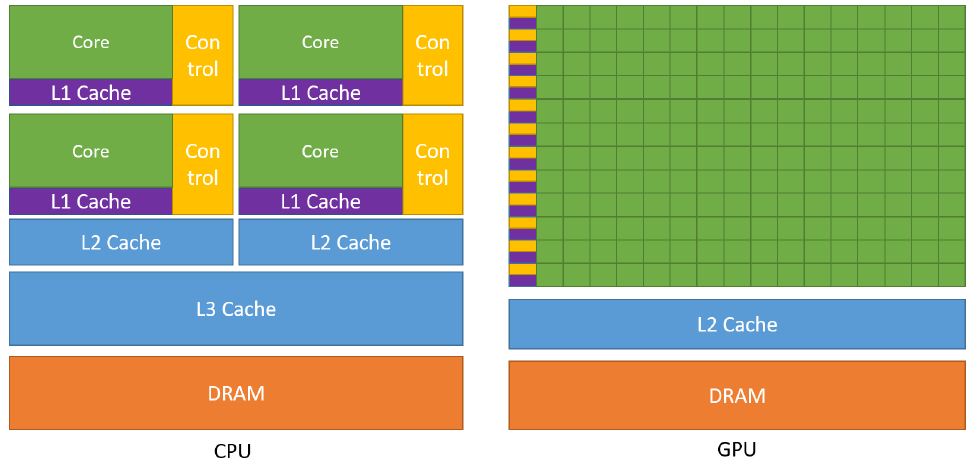
相同面的晶体管它大概的计算能力是相似的,我们可以看到在这一个芯片上边。用来计算也就这些核 Core,这些核其实面积并不大,更多的这些晶体管的计算能力都是放在一些管理控制,输入,输出,还有一些存储等等。这也是 CPU 的一个特点,把更多的资源向数据的管理,数据内容存储方向倾斜。
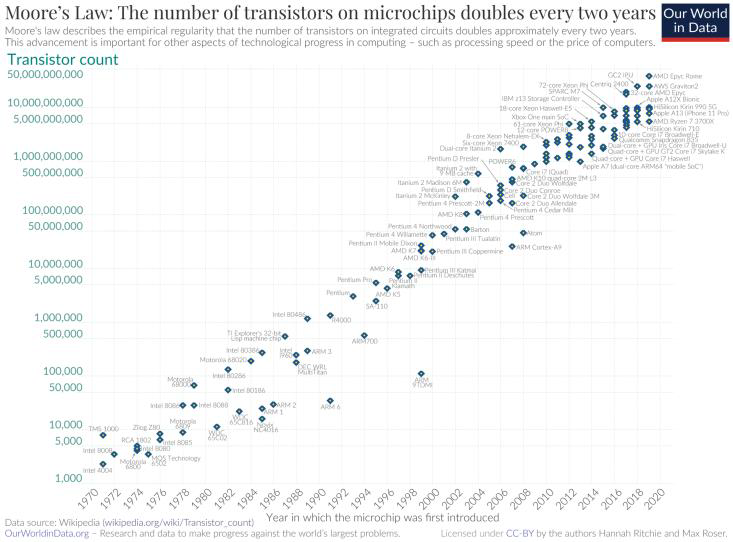
摩尔定律 MOORE’S LAW #
芯片的集成密度每 2 年翻翻,成本下降一半。
The complexity for minimum component costs has increased at a rate of roughly a factor of two per year
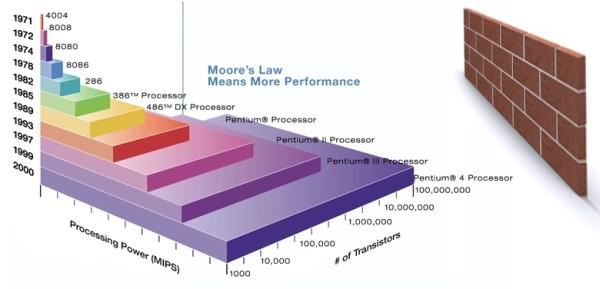
常规传统单核处理器遇到物理约束
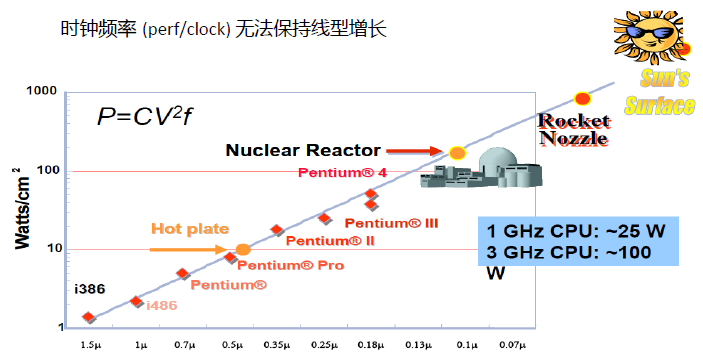
存在时钟频率墙,存储器墙等等。
时钟频率墙:当时钟频率越来越高,也就是芯片上边容纳的晶体管越来越多的时候。它的散热会出现问题,这层小于两纳米的时候还可能出现电子间的扰动。能量密度甚至高出了核电站的能量密度,再往后发展,甚至能够接近太阳表面的能量密度,很难掌控。
存储器墙:当处理器厂商意识到单纯依靠提高处理器频率并不能持续提升计算性能时,便把目光转向了利用多核心并行计算技术来提升计算性能,同时也希望该技术能缓解内存瓶颈。但处理器核心越多,性能就越高吗?实际情况并没有那么简单,除了如何有效地给多核心分配任务这一难题之外 (核心越多,任务分配的难度越大),多核心并行计算还遭遇到了更为严重的“内存墙”问题。这是因为在高度并行的处理方式下,多核心共享有限的内存带宽将会造成更大的延迟,就好像一条高速公路只有 4 条道,却有 4 辆以上的车要并列行驶,当然会造成道路拥堵、行驶缓慢了。
GPU VS CPU #
CPU’s issue :
- 大部分的能量都花在了控制上而不是计算上
- x86 ISA 指令集不够高效 Wall :
- Power Wall
- Memory Wall
- ILP Wall
GPU 架构的基本原理 #
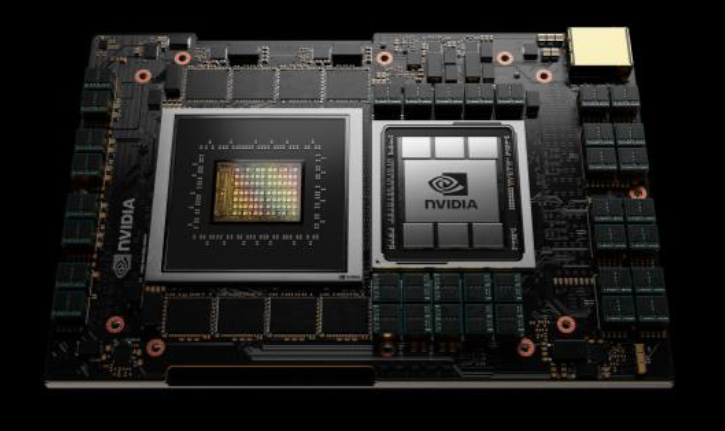
现在的 CPU 系统已经遇到各种瓶颈,只能向多核及并行系统发展顺势而生的 GPU(Graphics Processing Unit)。
GPU 计算性能 #
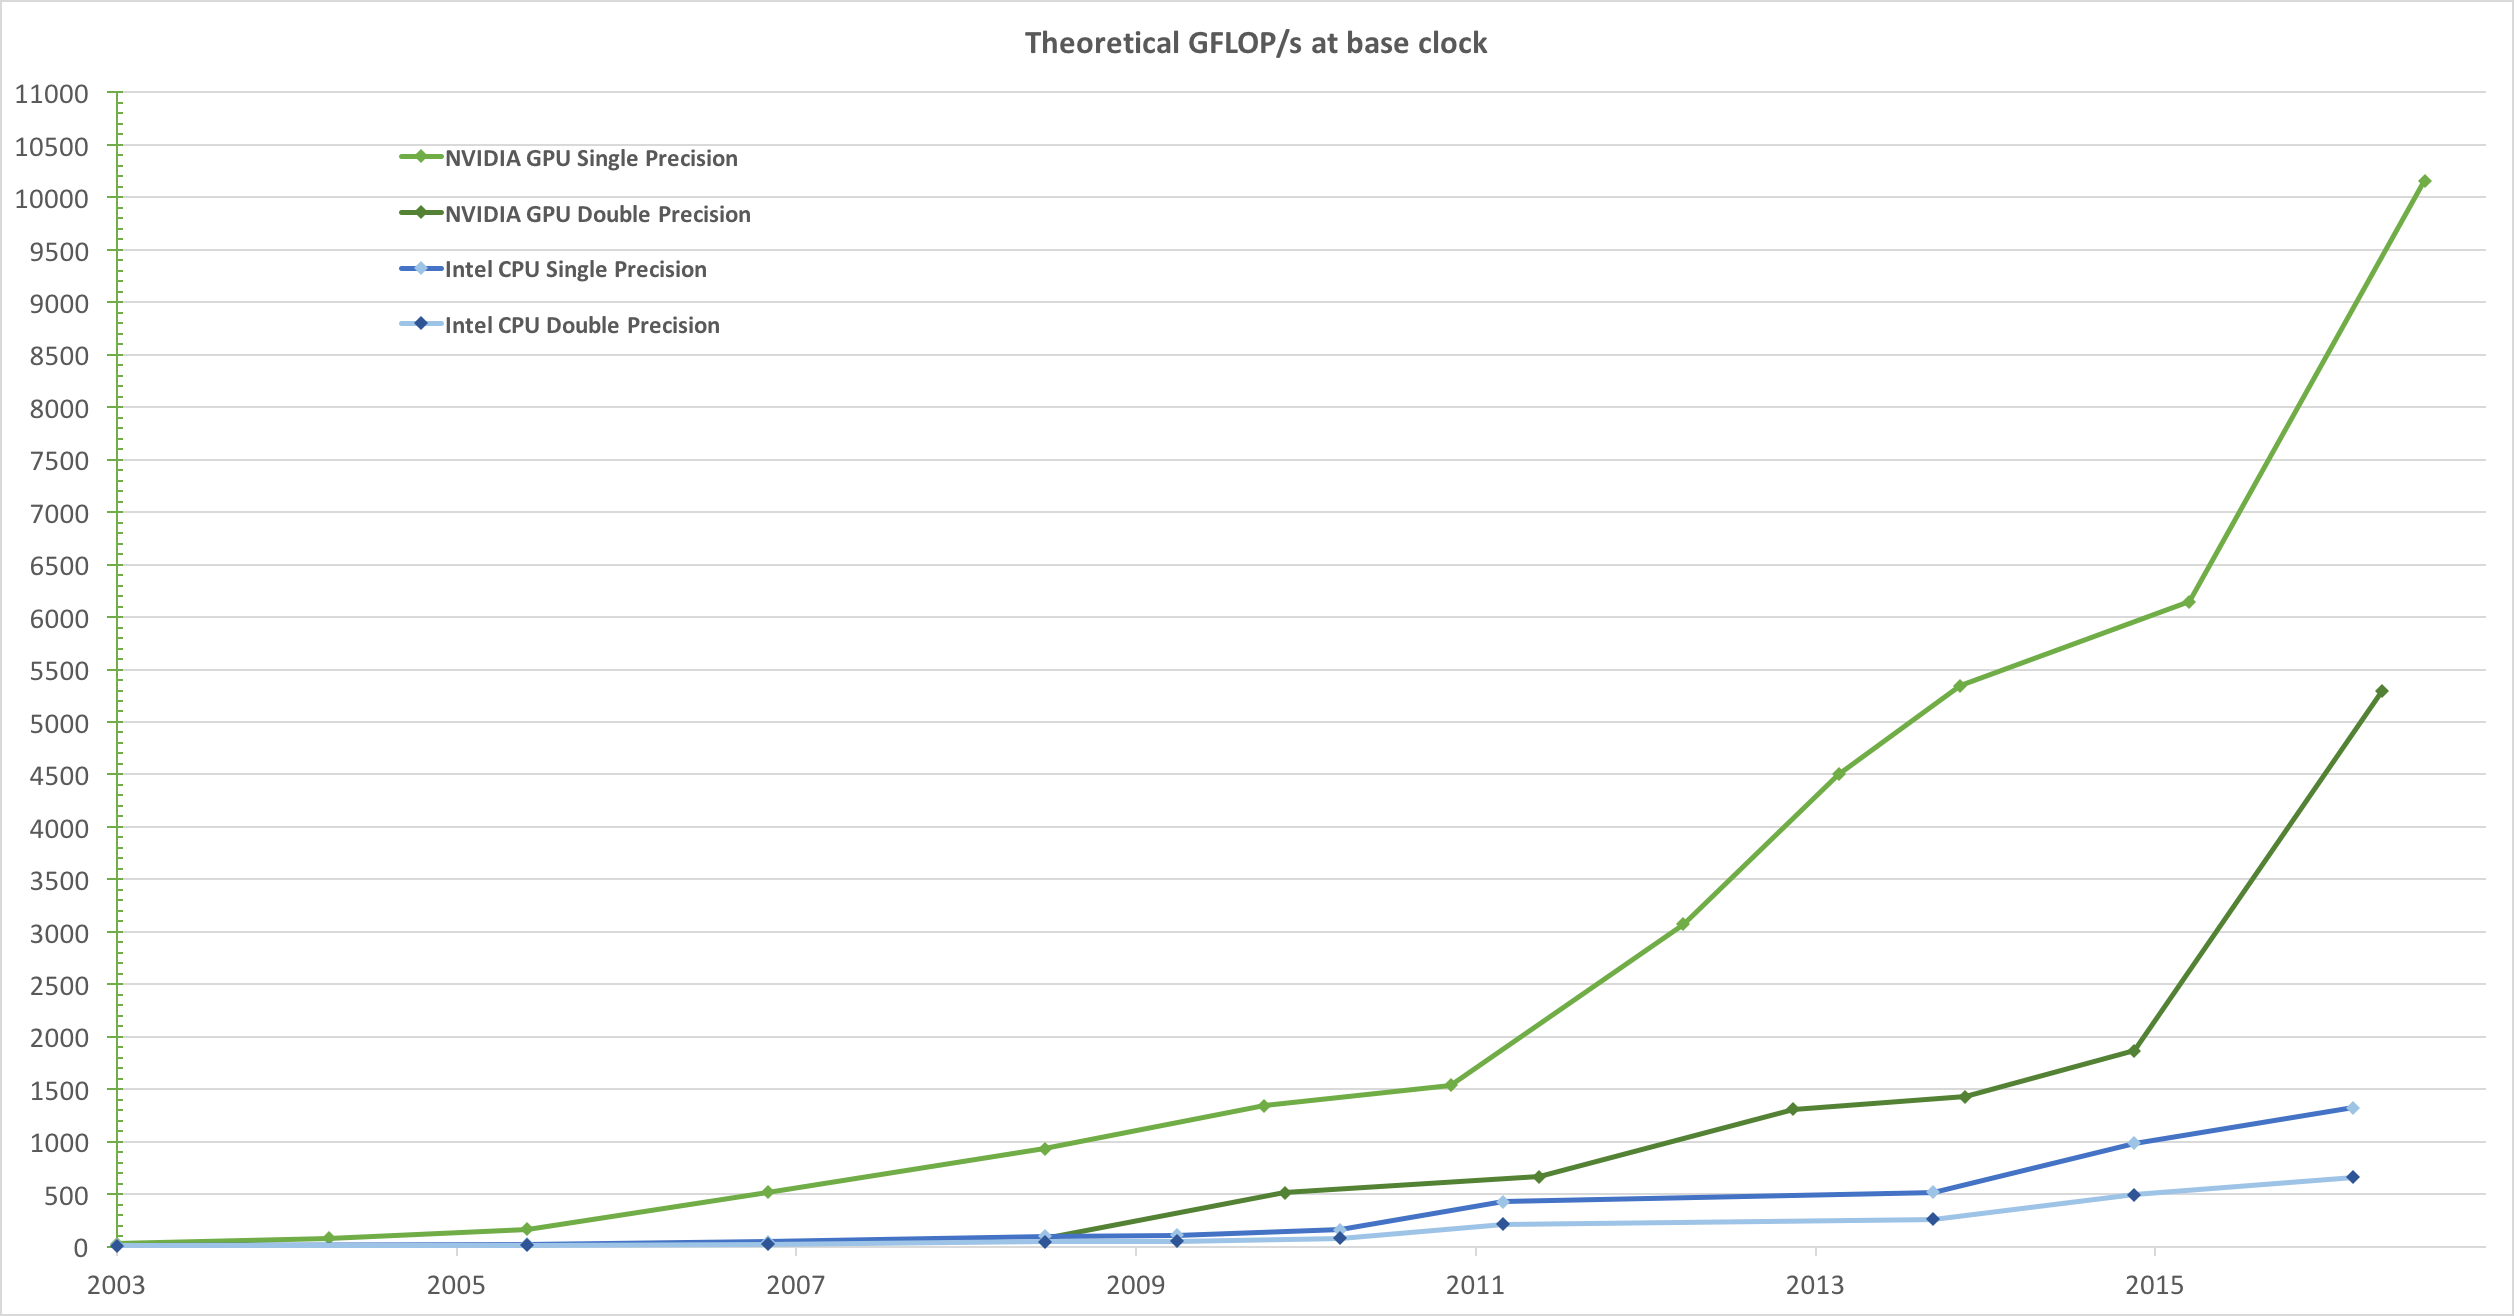
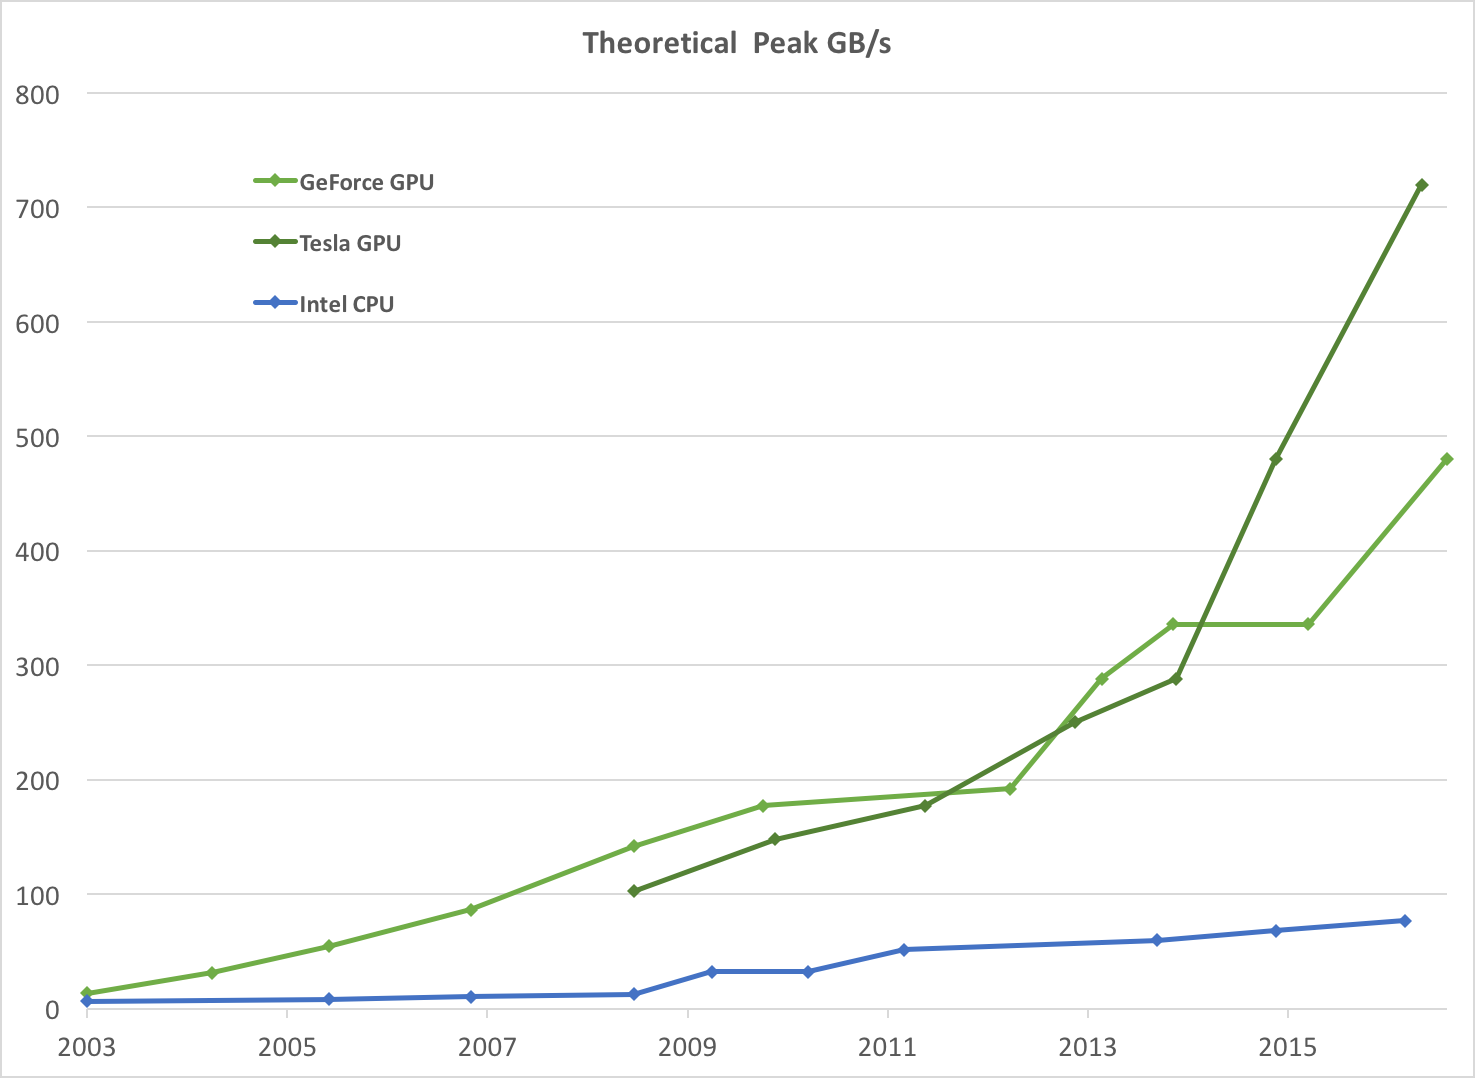
GPU 数据传输带宽 #
CPU 类型的内核 #
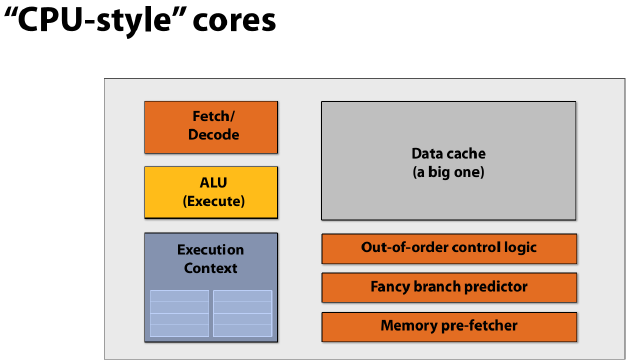
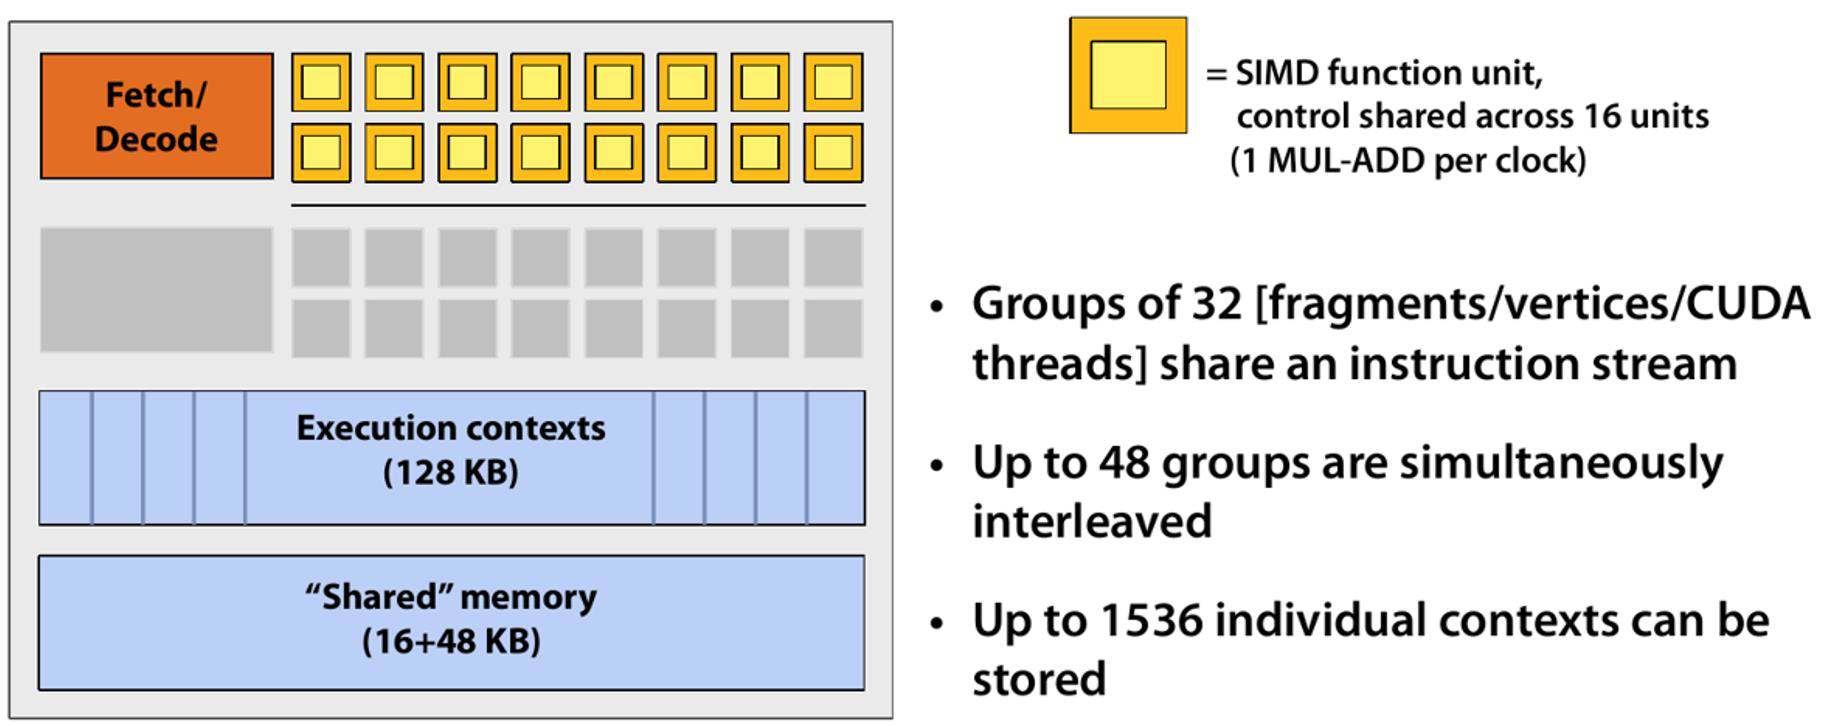
主要有取指译码,ALU 执行单元,执行上下文单元存储一系列的指令,还有一个大 cache。还有乱序执行,分支预测,存储单元的预获取等等。
这里将用于计算的单元进行一个精简展示:
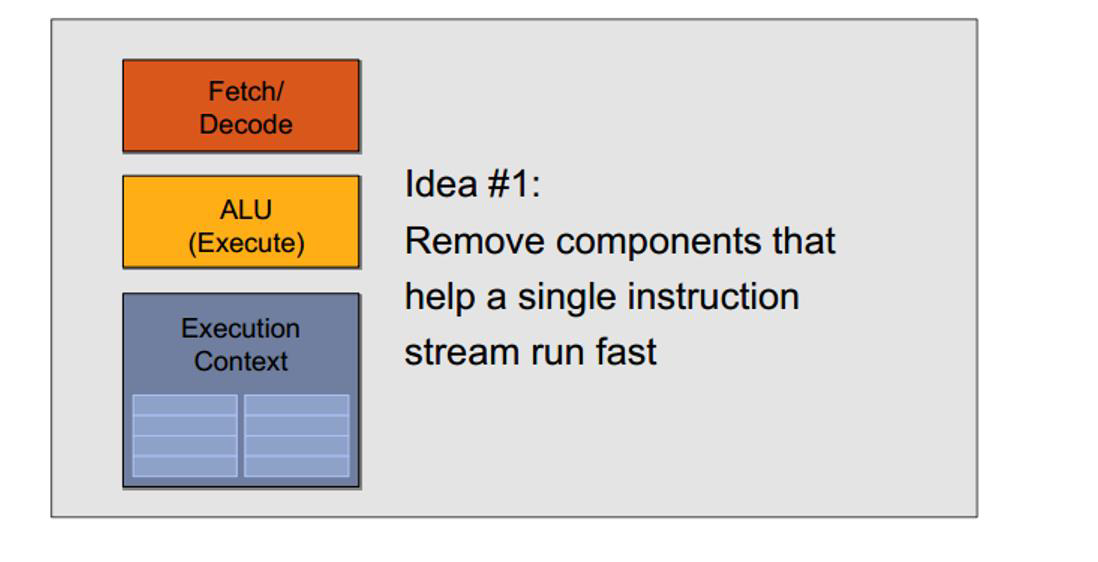
然后将计算核心重新组合在一起:
CUDA CORE:
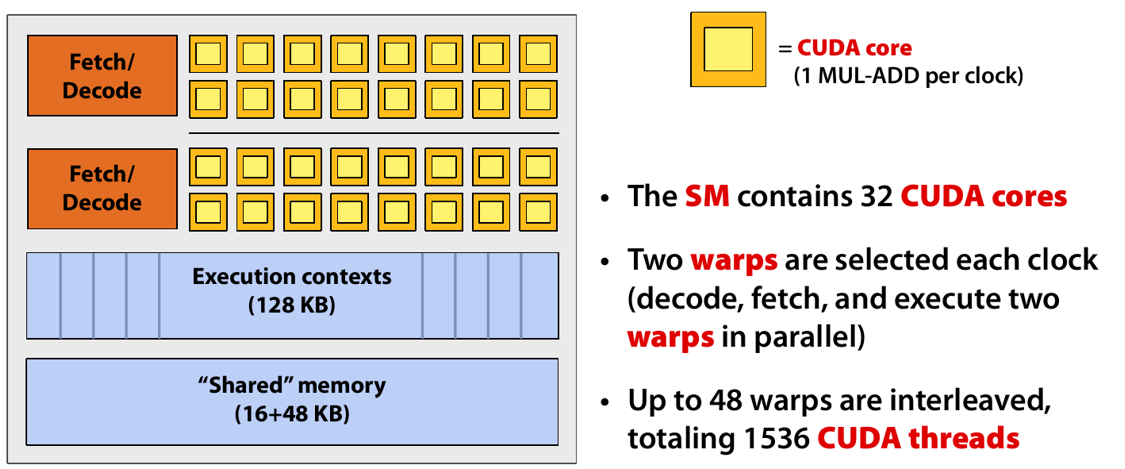
将这样的架构称为流式多处理器(SM——Stream Multi-processor),每个核心称为一个 CUDA 核,共享相同的计算指令,共享 shared memory
通过对比可以发现,GPU将更多的资源留给了计算:
GPU结构 GA 100 #
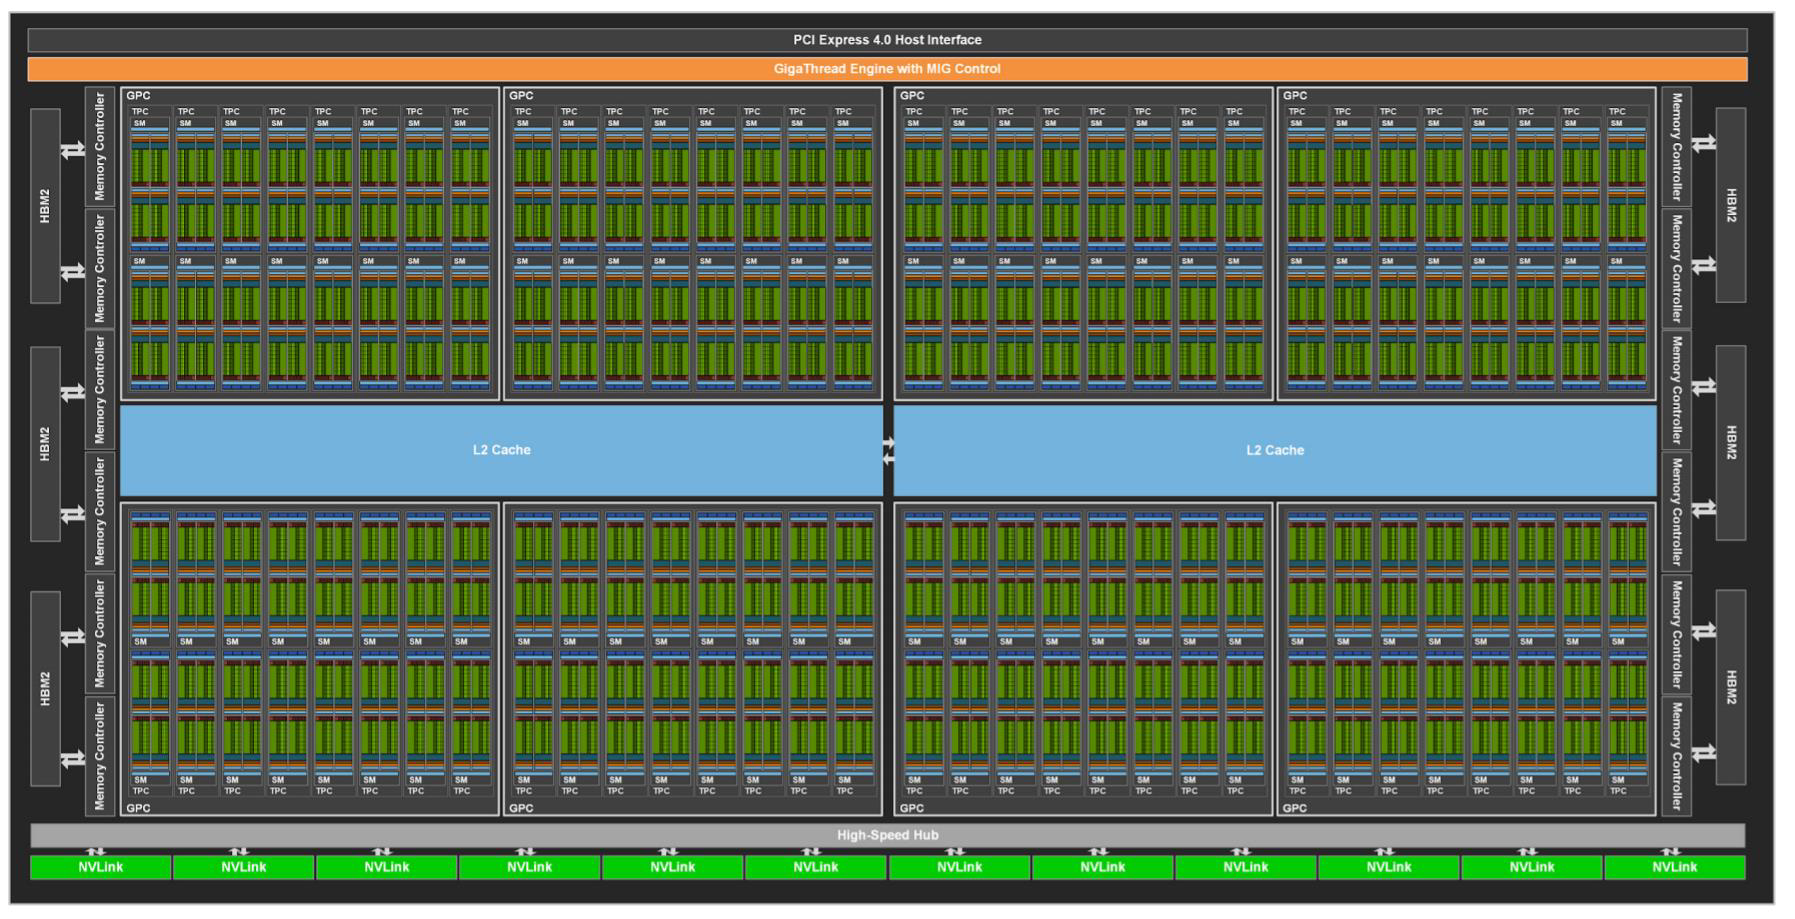 每个绿块就是一个 SM,多个 SM 组成一个 TPC,多个 TPC 组成一个 GPC。
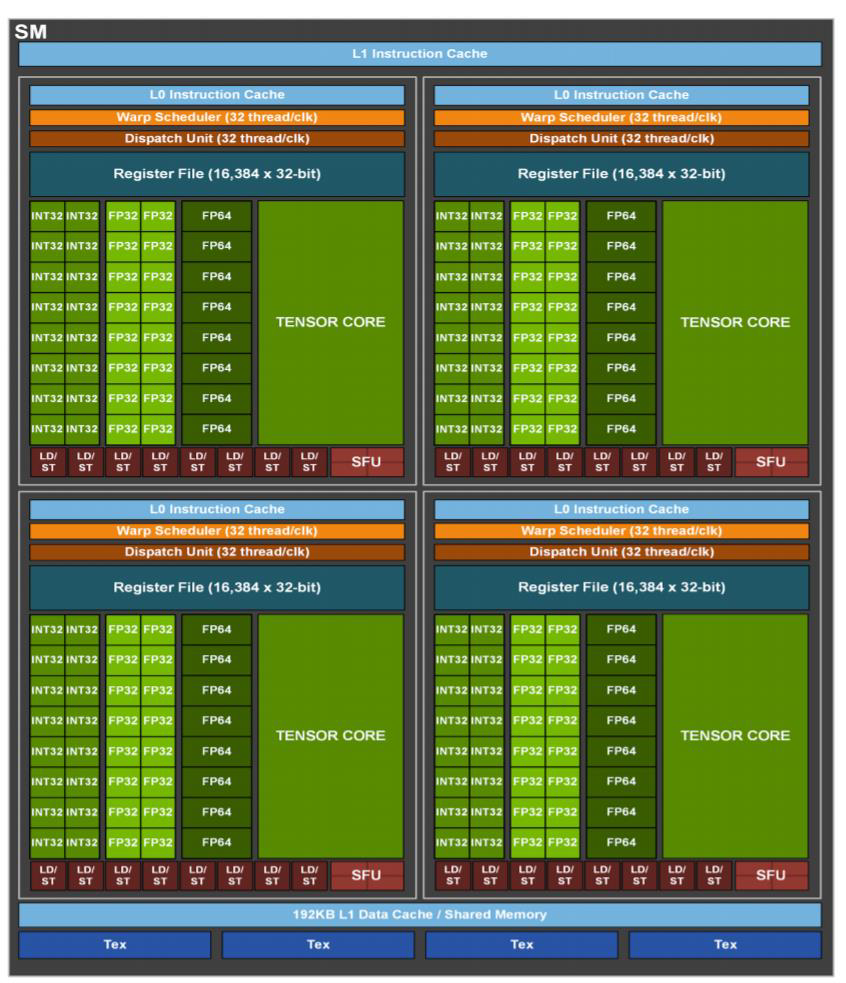 每个 SM 的内部构造如上图所示,有各种精度的计算单元,还有私有的寄存器,还有 32 个 CUDA 核组成了一个 warp,称为 1 束,硬件层面上共享相同的指令,在物理和硬件上是并行的,此外,还有存储器的 cache 等等。
- 8 GPCs, 8 TPCs/GPC, 2 SMs/TPC, 16 SMs/GPC, 128 SMs Per full GPU
- 64 FP 32 CUDA Cores/SM, 8192 FP 32 CUDA Cores per full GPU
- 4 third-Generation Tensor Cores/SM, 512 third-generation Tensor Cores per full GPU
- 6 HBM2 stacks, 12 512 Bit memory controllers
以下是关于 A 100 的基础参数:
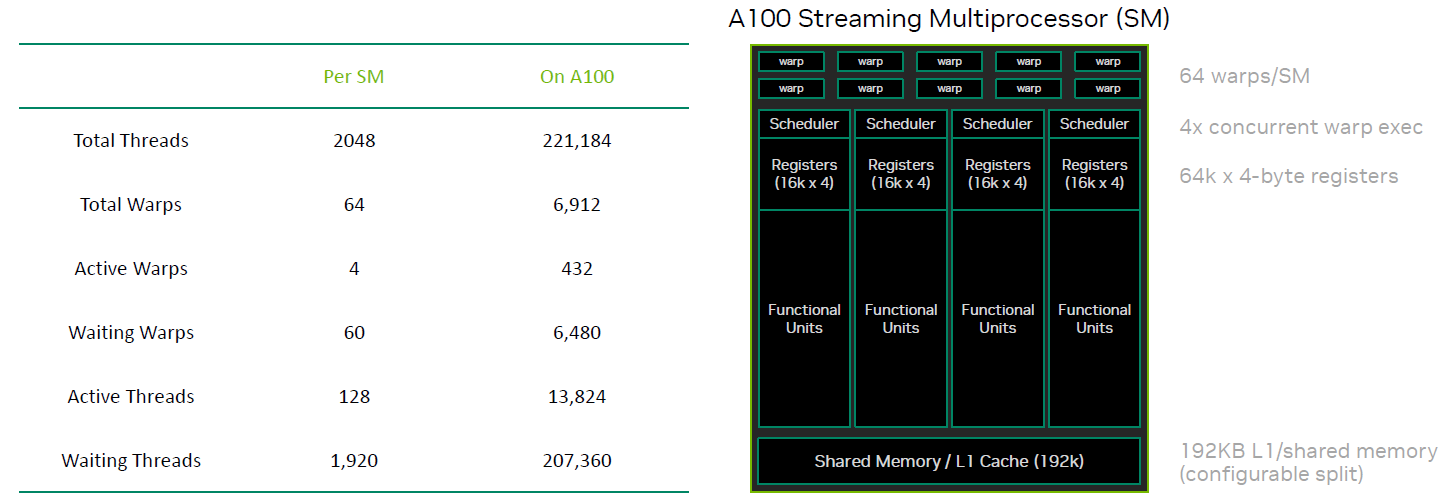
The GPU can switch from one warp to the next in a single clock cycle
GPU 硬件平台 #
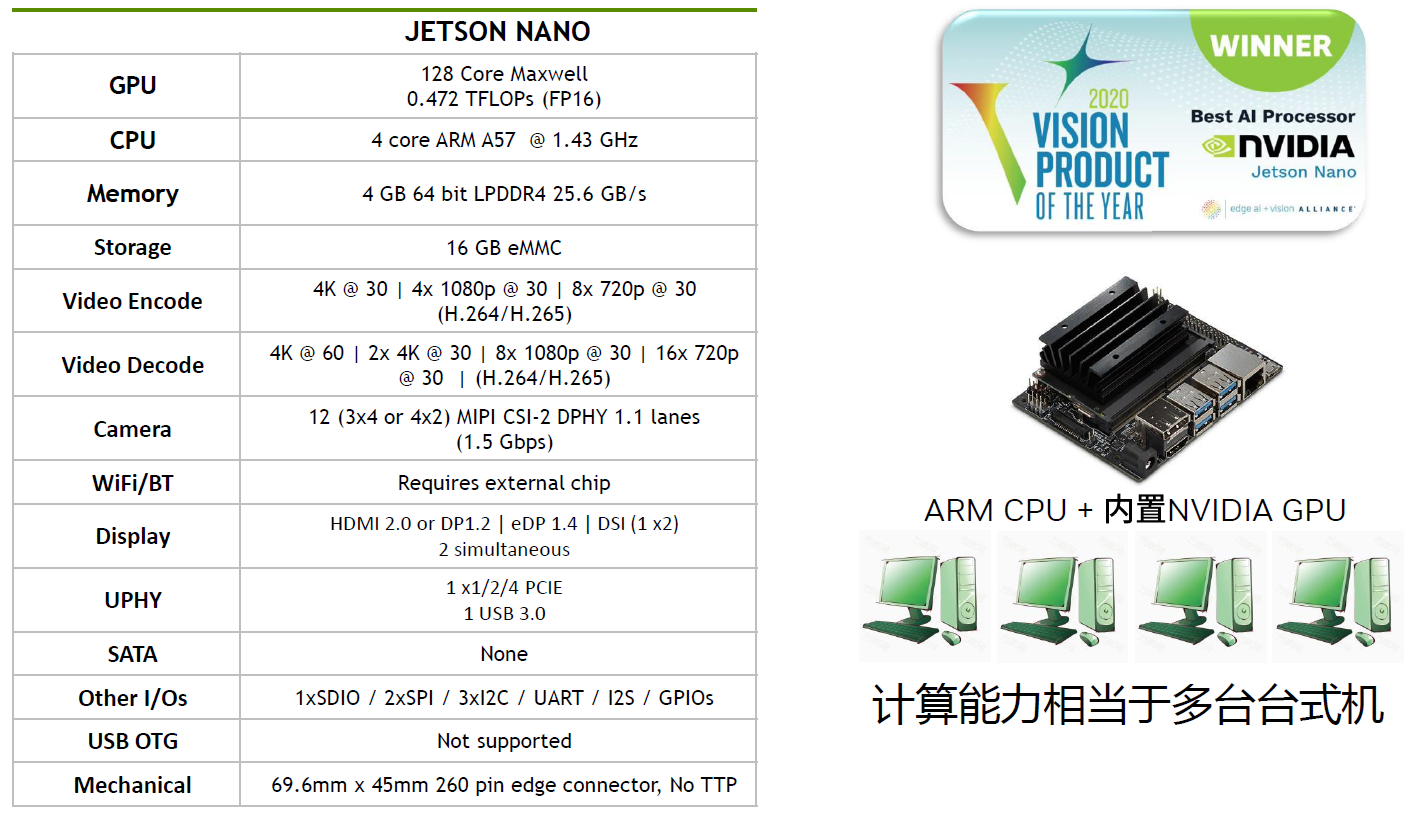
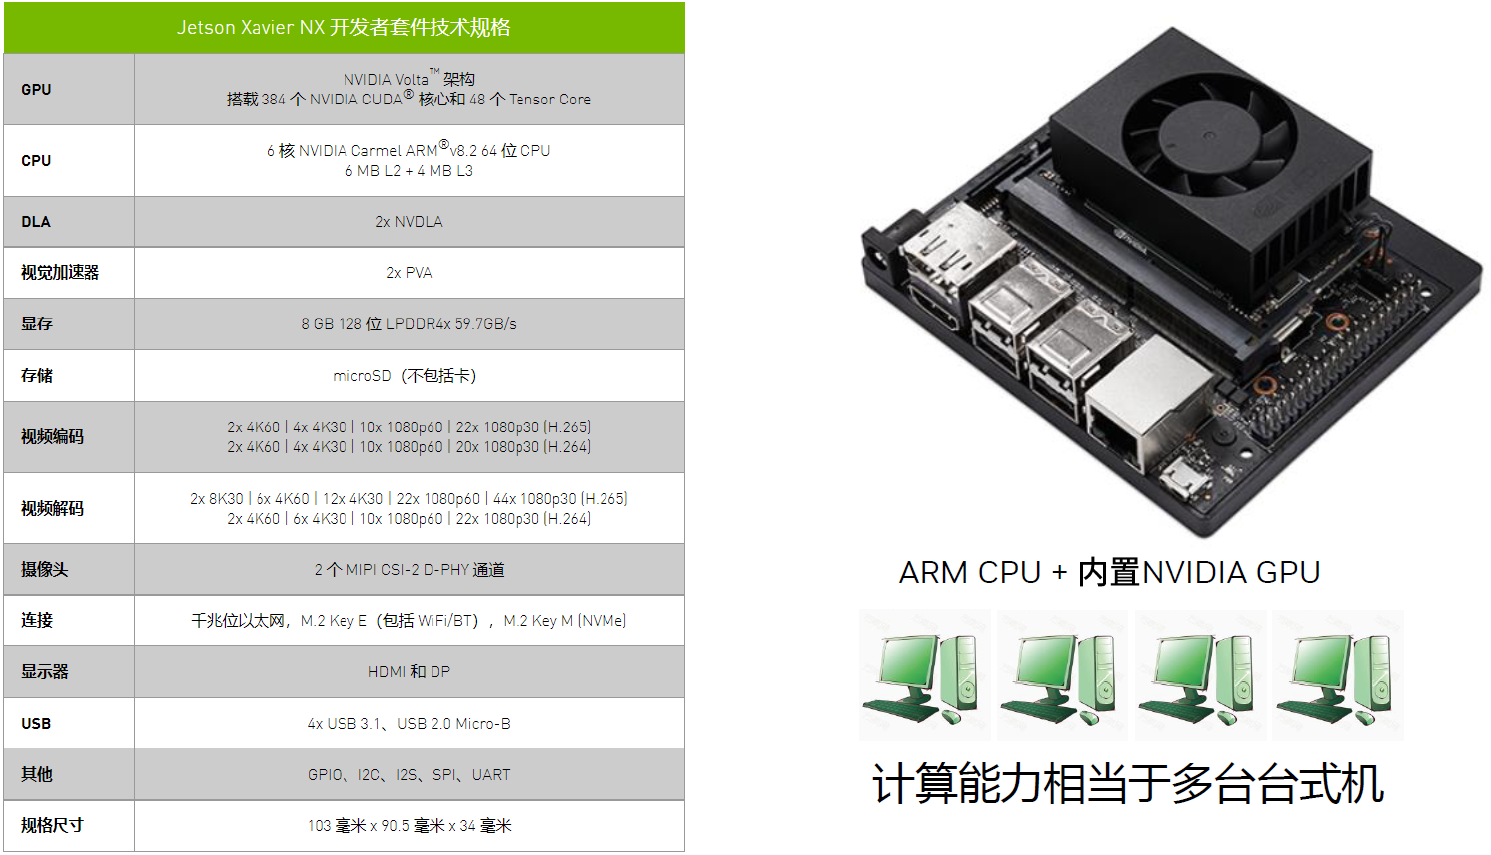
以下并不是一个独立的 GPU,而是相当于 arm 的 CPU+内置的 GPU 的组合:
关于 Jetson Nano #
关于 Jetson NX #
基于 Arm 和 GPU 的平台架构 #
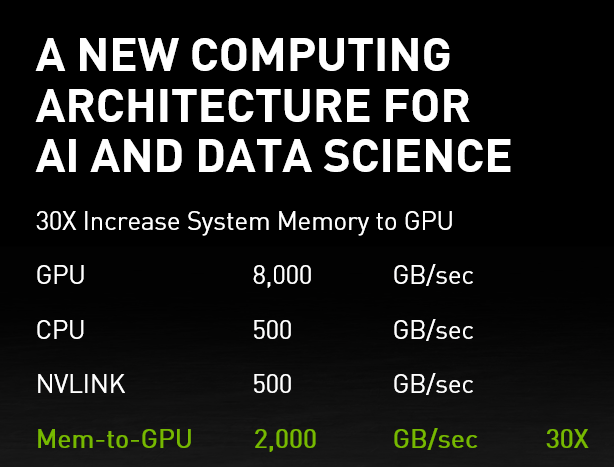
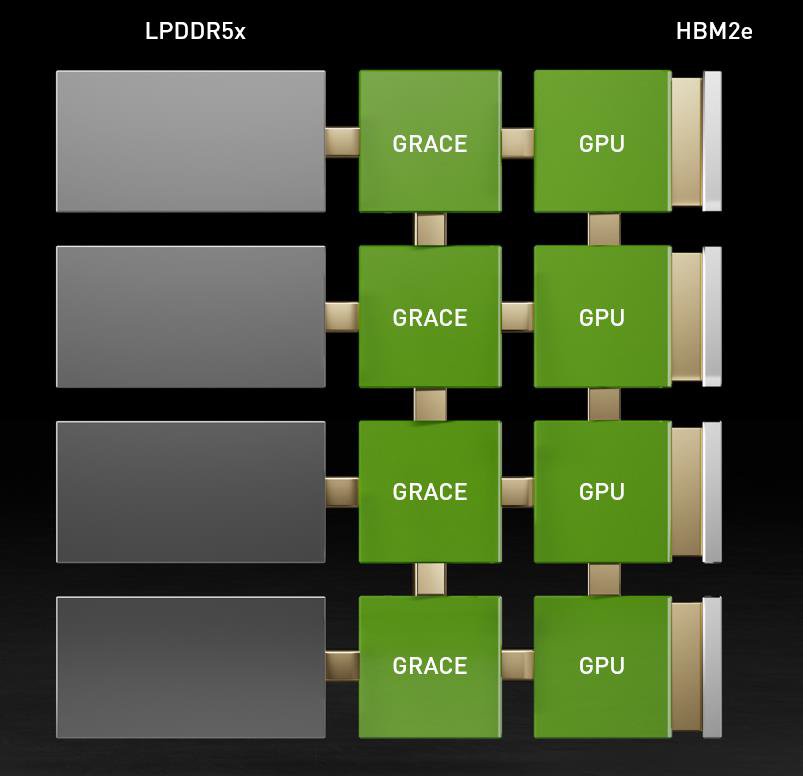 最近提出的一个 GraceHopper 的架构,就是一个 arm CPU + GPU 的方案。通常以前的 CPU 和 gpu,如果一个独立的 gpu,它没办法去直接访问你 CPU 的内存的。同样 CPU 也没法去直接访问 gpu 的内存。但是这在将来可能被打破。
GraceHopper 超级芯片是英伟达新推出的人工智能超级计算平台 DGXGH200的核心,该平台共连接256个 GH200芯片,高达144TB 的共享内存是 DGXA100超算的500倍,可以让开发者更好地开发人工智能大模型应用。
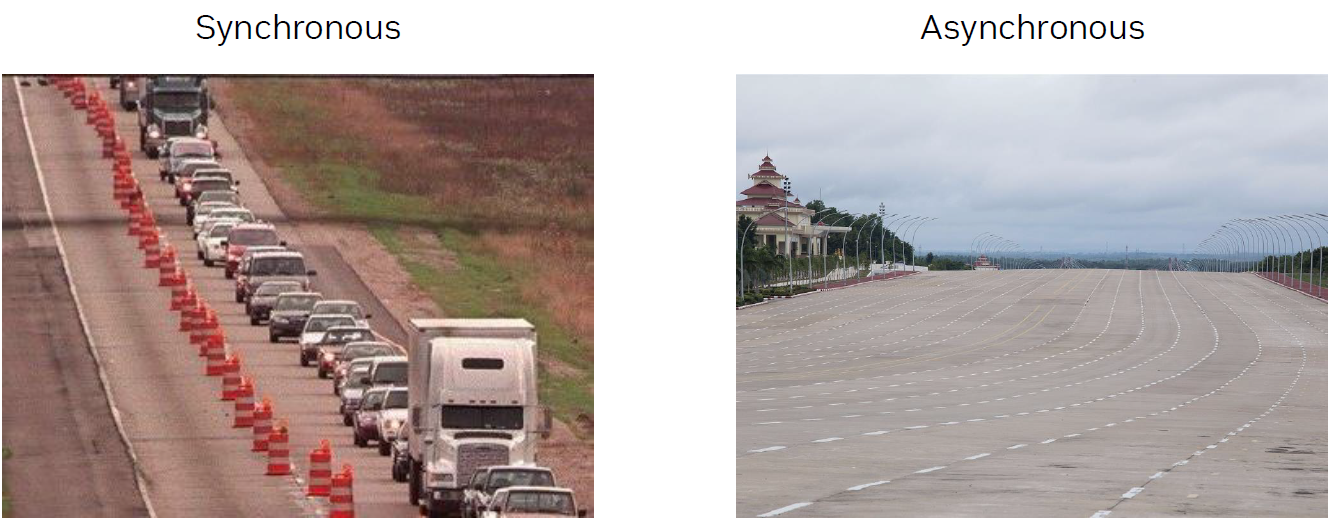
CPU 处理披萨快递 #
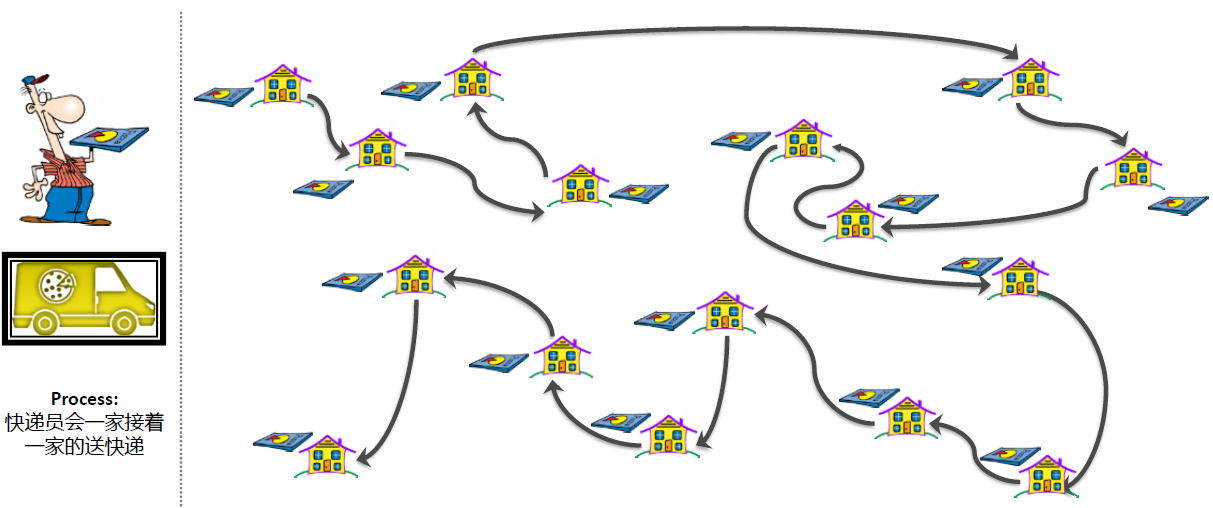
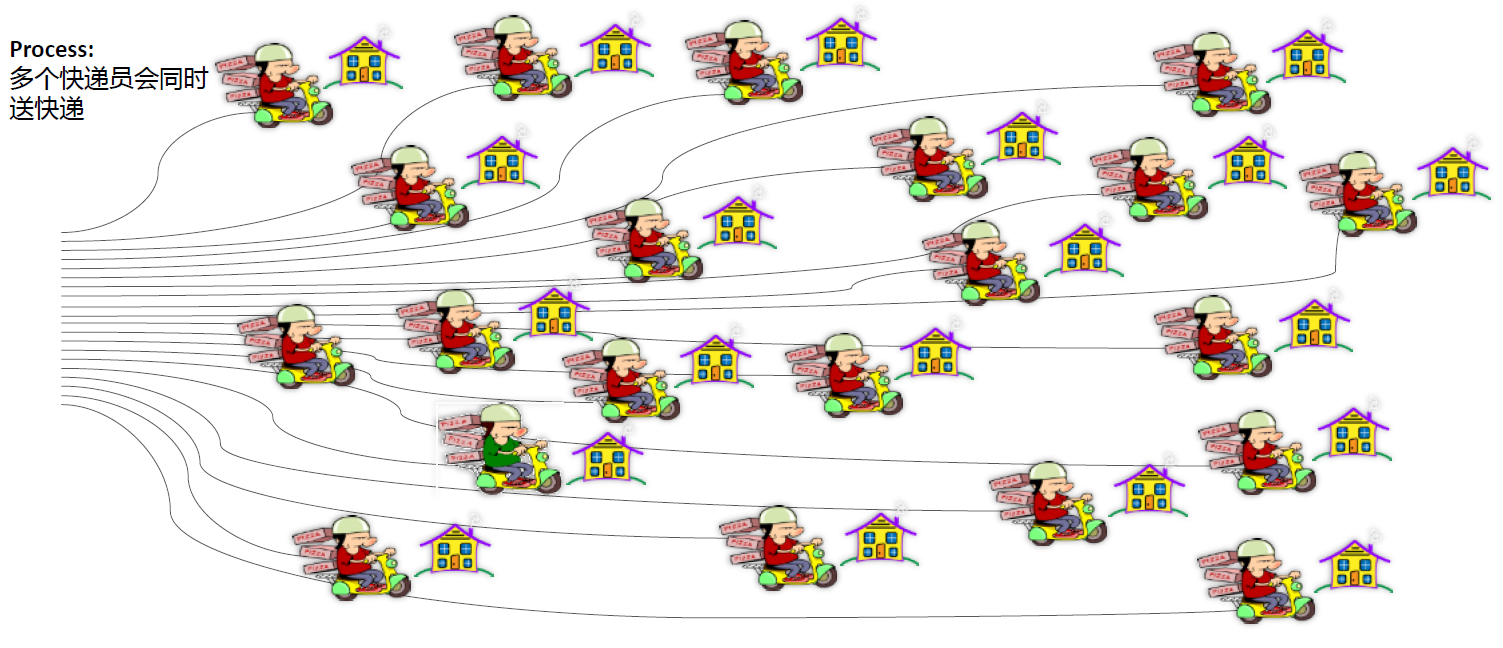
有点类似于同步和异步的处理方式:
CUDA 并行计算模式 #
一句话:并行计算是同时应用多个计算资源解决一个计算问题
- 涉及多个计算资源或处理器
- 问题被分解为多个离散的部分,可以同时处理(并行)
- 每个部分可以由一系列指令完成
最好是计算密集的任务
- 通信和计算开销比例合适
- 不要受制于访存带宽(例如一个程序的本身访存带宽占了程序 90%的计算开销,就没有必要对剩下的 10%进行优化,寻找不受带宽限制的计算任务)
适合处理:单一指令或少指令的大数据集任务
Amdahl’s Law #
Amdahl’s Law[2] 程序可能的加速比取决于可以被并行化的部分。
$$ speedup = \frac{1}{1-P} $$- 如果没有可以并行化的, P = 0 and the speedup = 1 (no Speedup)
- 如果全部都可以并行化 , P = 1 and the Speedup is infinite (in theory).
- 如果 50% 可以并行化 , maximum speedup = 2.
如果有 N 个处理器并行处理:
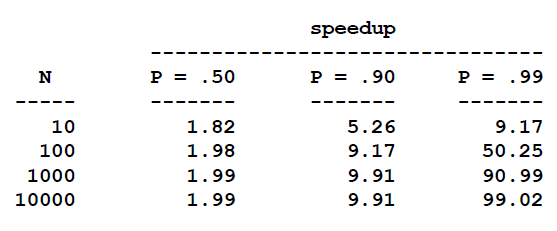
$$ speedup = \frac{1}{\frac{P}{N}+S} $$P = 并行部分 , N = 处理器数量 and S = 串行部分
并行化的可扩展性有极限
For example, at P = .50, .90 and .99 (50%, 90% and 99% of the code is parallelizable)
References
Related readings
- Introduction to CUDA and Linux Basics
- Introduction to CUDA
- AI开发硬件环境综述
- Overview of the AI Development Software Environment
If you want to follow my updates, or have a coffee chat with me, feel free to connect with me: