Dividing Functionality with Classes
August 16, 2023 · 31 min read
If you have any questions, feel free to comment below. Click the block can copy the code.
And if you think it's helpful to you, just click on the ads which can support this site. Thanks!
理解类是运用设计模式的前提;运用类本身也能更好的组织代码,提升扩展性、可读性、复用性。
from typing import Callable, Tuple, List, Sequence
from pandas import DataFrame
功能划分:理解并运用类 #
为什么要使用类 #
使用类可以项目结构的基础上在更进一步:
- 同一个功能模块(文件)内,继续细分多个子功能模块
- 以类为单位可以更细粒度的集成各种方法,更加准确的定位相关方法的位置,提高复用性
- 类的存在进一步明确了引用关系,避免连带bug产生
此外类还有独特的优势:
- 类的封装性,使得细分功能模块内部逻辑变动时,不用修改已经引用的代码
- 类的继承/多态性,使得复用代码时能很方便的微调代码
- 类是使用设计模式的前提
需要注意以上几点只是使用类在编程时带来的优势,并不是类的本质,其本质是对某一类对象的抽象。关于这点会在后面类的实例化部分提到。
首先解释前三点优势,以 data_save.py 为例,展示部分代码:
from pandas import DataFrame
from db import insert_df_pg, create_conn
from utils import turn_tuple_into_df
from psycopg2.extensions import connection


INSERT_TB = 'insert_table' # 处理好数据存入的数据库表名
INSERT_SC = 'insert_sc' # 处理好数据存入的schema名称
INSERT_DB = 'insert_db' # 处理好数据存入的database名称
INSERT_COL_TYEPS = {'id': 'int4', 'flag': 'float4', 'time':'timestamp'} # 插入数据库表的字段名与字段类型;因为会被下方多个函数引用,所有定义成全局变量


def check_tb() -> bool:
    '''
    检查用于插入处理好的数据表是否存在以及是否符合要求
    '''

    if conn is None: # 如果没有生成数据库链接对象则生成
        conn = create_conn(db_type='pg')
    cur = conn.cursor()

    # 生成查询数据表信息的sql语句
    sql_info = f'''select column_name, udt_name from information_schema.columns
    where table_schema = '{INSERT_SC}' and table_name = '{INSERT_TB}' '''

    # 获取表字段,返回的是嵌套的tuple结构((), (), ());如过为空则是一个空tuple
    with conn, cur:
        cur.execute(sql_info)
        info_raw = cur.fetchall()
    conn.close()

    if not info_raw: # 返回的是空tuple说明不存在这个表
        return False

    info_df = turn_tuple_into_df(info_raw, col_names=['col_name', 'data_type']) # 转化为dataframe

    # 检查是否有字段缺失
    df_cols = info_df.columns.to_list() # 输入的数据列名
    missed_cols = set(INSERT_COL_TYEPS.keys()).difference(df_cols) # 查看缺失哪些字段
    if missed_cols:
        return False

    # 检查字段是否符合要求
    col_type_check = info_df.apply(lambda sr: INSERT_COL_TYEPS[sr['col_name']] == sr['data_type'], axis=1)
    if not col_type_check.all(axis=0):
        return False

    return True # 都没有问题,返回True

# 剩余代码见文件`data_save.py`
...
data_save.py 的功能是将数据储存至数据库,而上述代码其实就定义了四个函数 check_tb, drop_tb, create_tb, insert_data;虽函数数量不多,但各函数内部逻辑也不算简单,例如上文截取的 check_db 函数。
协作者或间隔一段时间后的代码作者本人,也需要仔细阅读才能理解代码功能和各代码之间的关系。但是当使用类后(完整代码见 data_save_with_class.py):
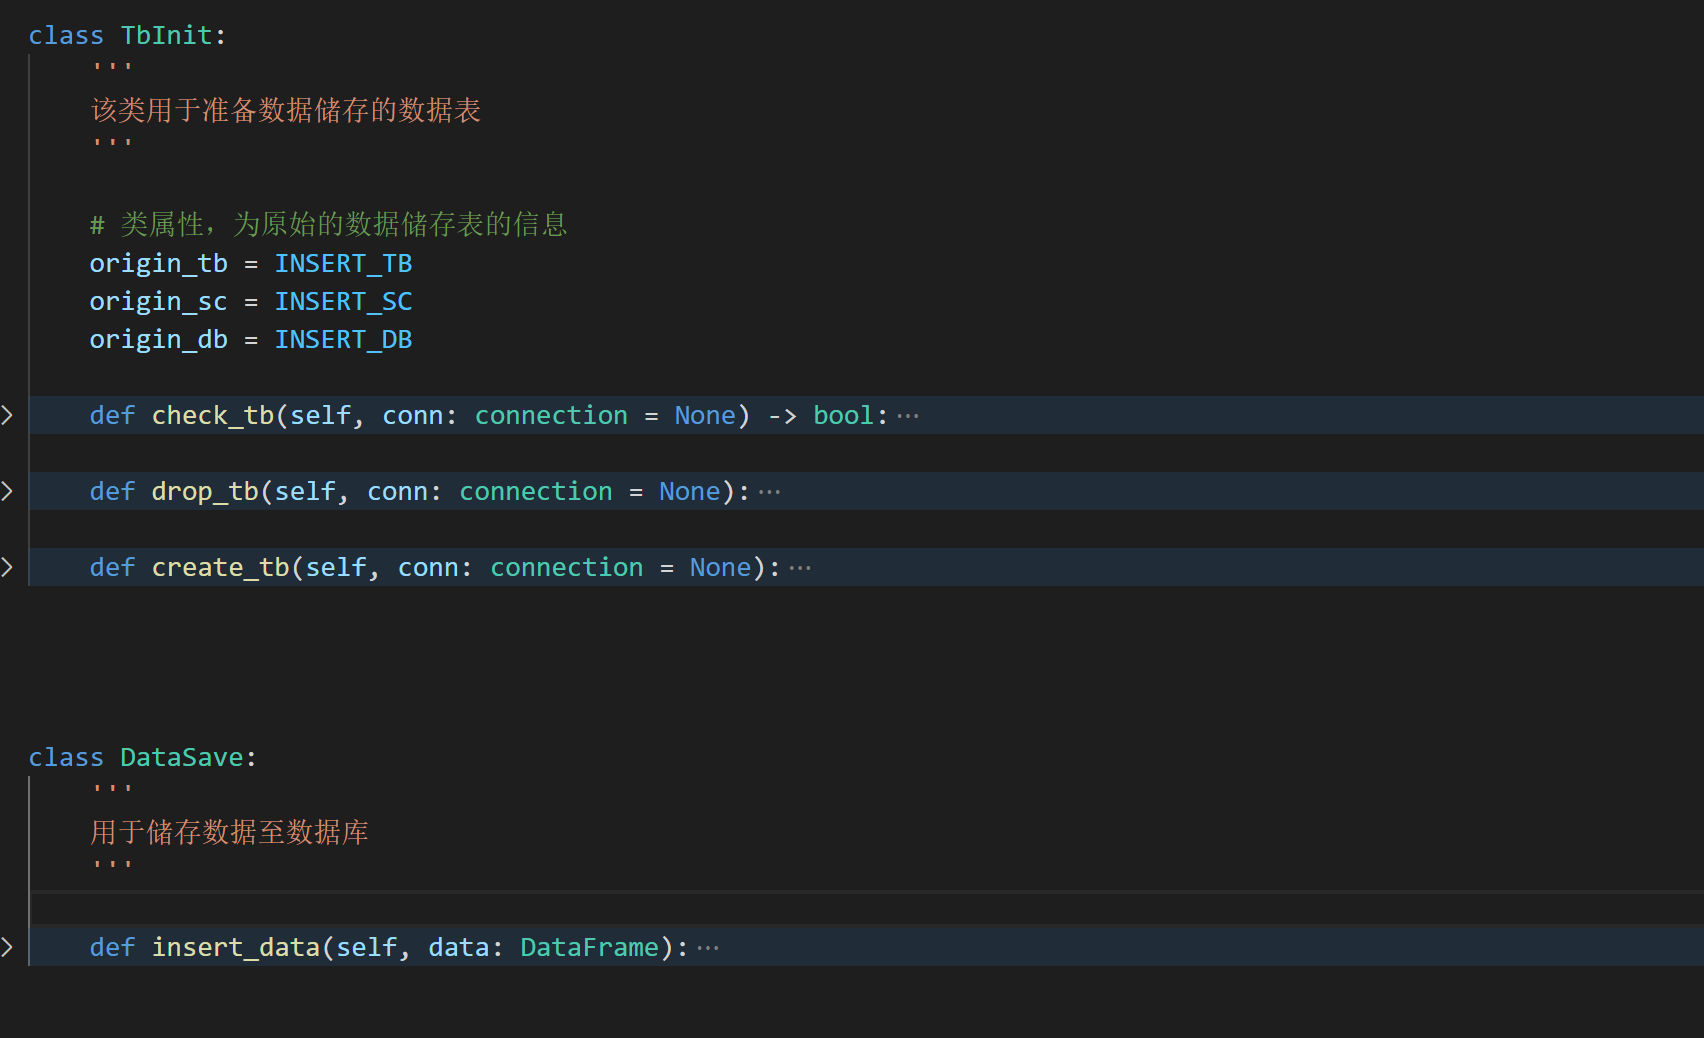
可以很清楚的看到 check_tb, drop_tb, create_tb 都在 TbInit 类下, insert_data 归于 DataSave 类
通过类描述也能够了解,data_save.py这个功能模块,细分为两部分即:
- 准备数据库表
- 执行数据储存 这样我们不用仔细阅读每个函数的实现逻辑,也能大致理解这个功能模块中有哪些细分功能
而实际情况中,一个功能模块用到的函数往往不止4个;各功能需求也会有变动,这给我们梳理函数引用关系,管理功能边界提出了更高的要求;对这种情况,类同样能帮到我们。
例如,现在对于data_save.py增加了需求
- 对于数据储存的部分,增加更新数据的功能
- 增加数据迁徙备份的功能
为此我们
- 对于需求1,在
DataSave类下添加get_old_data方法,检查数据中有哪些已存在,稍后进行更新 - 同样对于需求1,在
DataSave类下添加update_data方法更新数据 - 在
DataSave类下添加内部方法_detect_missed_col用于检查有哪些字段缺失
由于类中的三个实例方法都有这一段逻辑,所以单独做一个类方法便于复用 - 对于需求 2,由于细分功能不一致,我们添加
DataMove类
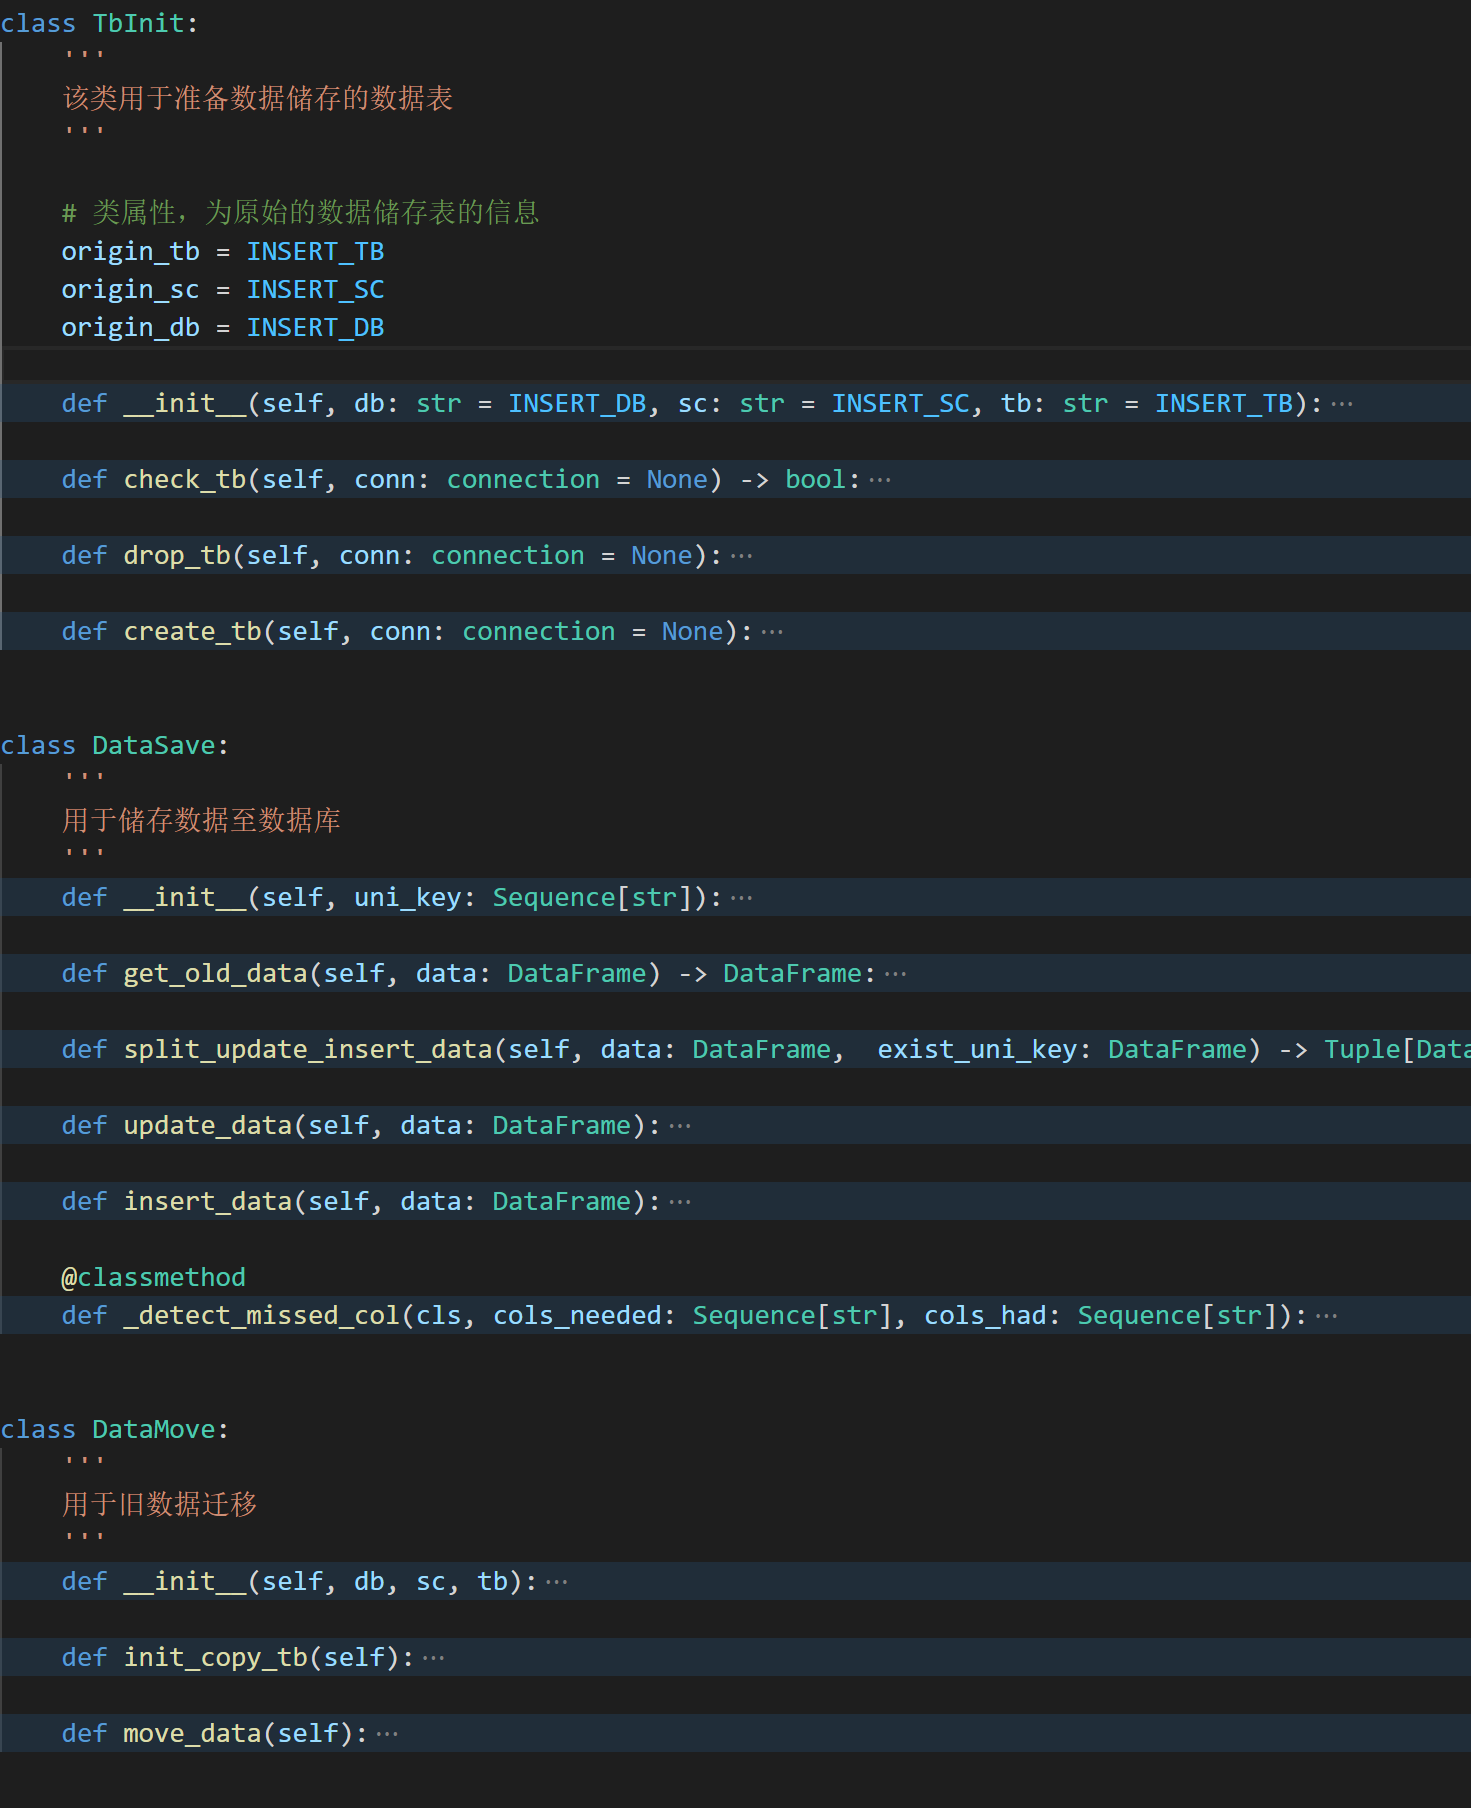
可以看到,data_save.py 内的功能划分很清楚
- 想要复用关于准备数据库表的功能,到
TbInit类下去找; - 想要找数据变动相关的功能,到
DataSave类下找 - 需要复用数据迁移的功能,则到
DataMove类下找;
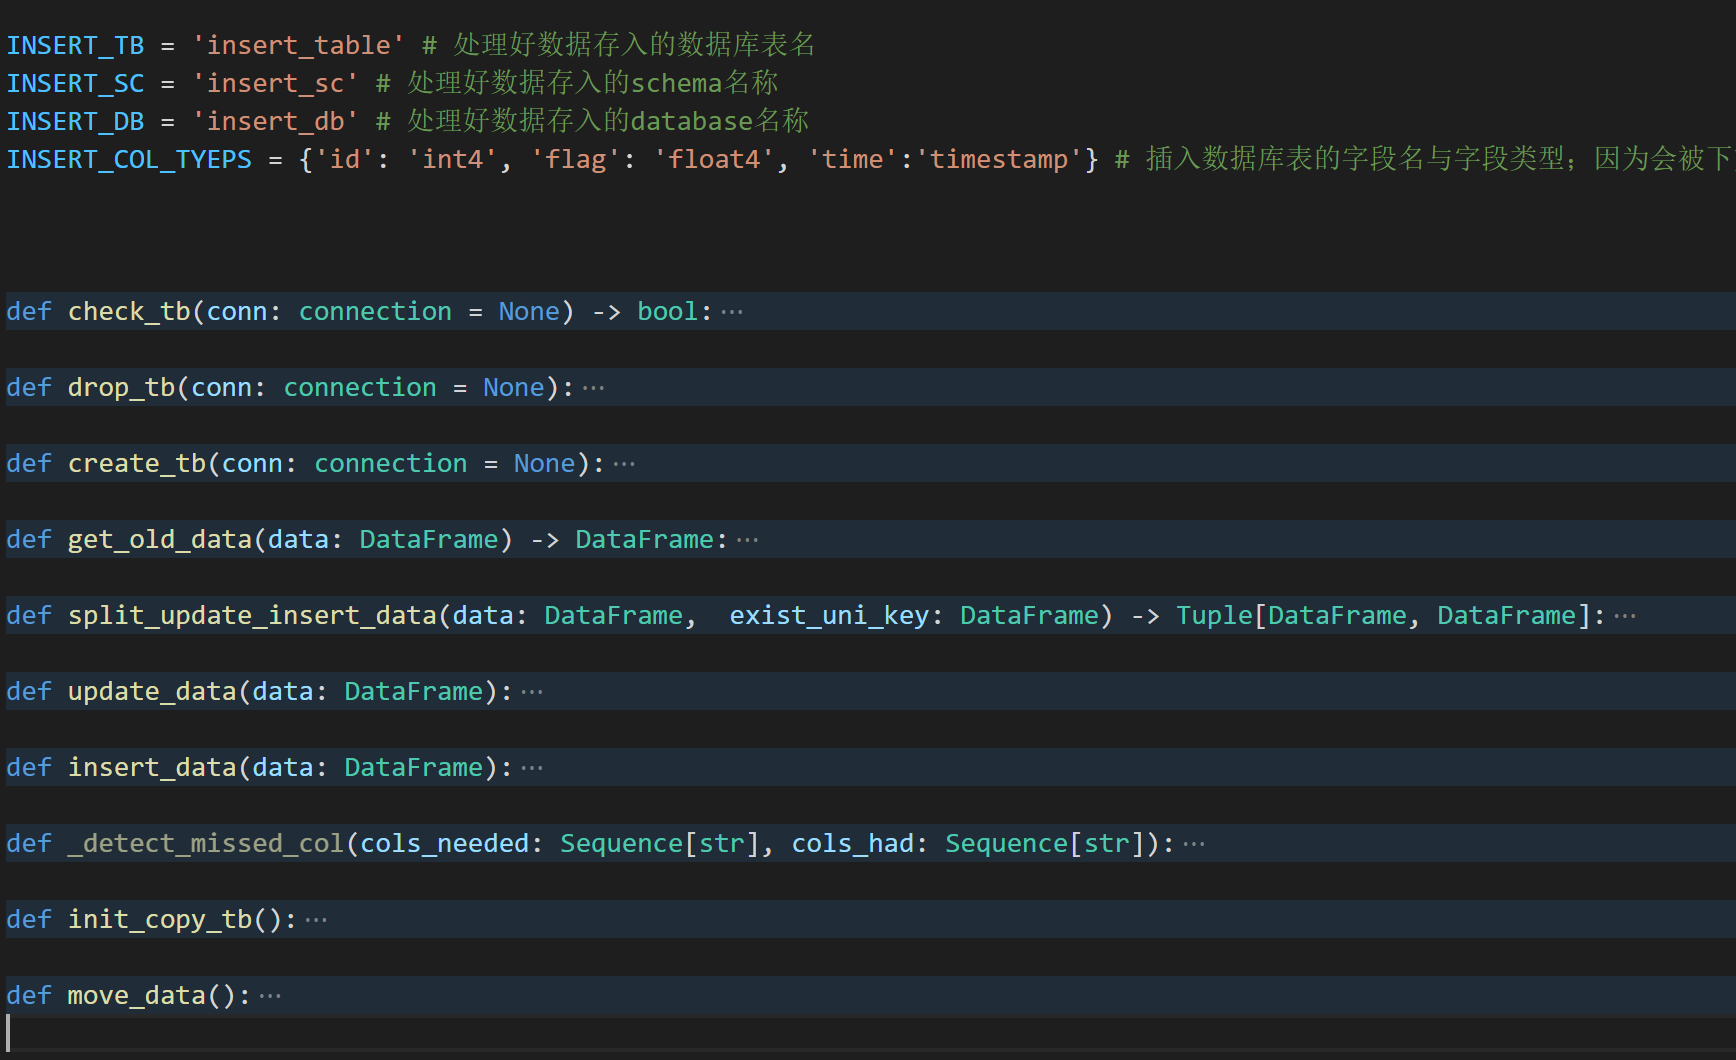
如果没有类,我们面对的则是10多个互相引用的函数,很难理清函数间的引用关系并快速根据需求找到想要的代码。以下是没有类的情况,看起来十分杂乱:
此外,功能模块内部引用关系也很明确,可以看到 DataMove.init_copy_tb 中有实例化 TbInit 并运用其方法的过程
# 完成代码见`data_save_with_class.py`
class DataMove:
    '''
    用于旧数据迁移
    '''
    def __init__(self, db, sc, tb):
        '''
        :param db: 迁移表的database
        :param sc: 迁移表的schema
        :param tb: 迁移表的表名
        '''
        self.db = db
        self.sc = sc
        self.tb = tb

    def init_copy_tb(self):
        '''
        初始化用于储存迁移数据的表

        '''
        tb_init_ins = TbInit(self.db, self.sc, self.tb) # 实例化,为后续使用"准备数据表"功能做准备
        is_tb_ready = tb_init_ins.check_tb() # 检查迁移表是否满足要求
        if not is_tb_ready: # 不满足
            tb_init_ins.drop_tb() # 删除迁移表
            tb_init_ins.create_tb() # 按要求创建迁移表
    ...
这就明确了 数据迁移功能 有引用 准备数据表功能,当 准备数据表功能 有变动时,提示我们要注意 数据迁移功能 的影响;如果函数很多,这样的引用关系有可能被忽视,从而引起意料之外的 bug。
什么是类&类的基本语法 #
实例化 #
对于上文DataMove.init_copy_tb中调用TbInit的部分,有可能会有疑问:
Python的类为什么不直接调用方法
TbInit.check_db(), 而是先要实例化tb_init_ins = TbInit(self.db, self.sc, self.tb)?
首先 TbInit.check_db() 这样的调用方式是存在的,这叫做调用 类方法 下文会提及,实例化后再调用的是 实例方法
其次,先实例化再调用 的方式和类的本质有关系:类是对同一种对象(概念)的抽象、总结和归纳;保留了此类对象的行为/能力的同时,移除了具体对象特有的属性
而实例化可以理解为赋予/还原了具体对象的特有属性,感性的理解可以是:
手机拨打电话功能已经存在(定义类),插入 sim 卡读取通讯录后(实例化),能够拨打具体每个通讯录联系人的电话。这就类似先实例化 tb_init_ins = TbInit(self.db, self.sc, self.tb) 再调用实例方法;**不同的实例,处理的是不同的数据库表。**同时110/120 可以直接拨打,这就类似于调用类方法 TbInit.check_db()。
__init__ 方法
#
此外__init__方法可能也是新手的理解难点,对此有如下解释:
- 实现实例化的方法, 实例化类的时候会调用这个方法;由它赋予具体实例对象的特殊属性;在
TbInit的实例化中,就是指定数据库表的信息 - 不需要手动调用,实例化时自动调用
- 一个类可以没有
__init__方法;当没定义__init__时,类实例化就只是生成一个实例,没有其他操作。
类的基本构成 #
构成及使用方法 #
属性
- 实例属性
- 类属性
方法
- 实例方法
- 类方法
- 静态方法
还是以TbInit为例展示类的各种构成,我们作如下改动
- 添加三个类属性
origin_tb,origin_sc,origin_db - 一个类方法
get_origin_tb_info - 一个静态方法
print_class_desc
class TbInit:
    '''
    该类用于准备数据储存的数据表
    '''

    # 类属性,为原始的数据储存表的信息
    origin_tb = INSERT_TB
    origin_sc = INSERT_SC
    origin_db = INSERT_DB


    def __init__(self, db: str = INSERT_DB, sc: str = INSERT_SC, tb: str = INSERT_TB):
        '''
        实例化时输入需要数据库表信息,不局限于全局变量中的数据库表,方便复用
        '''
        self.db = db
        self.sc = sc
        self.tb = tb

    def check_tb(self, conn: connection = None) -> bool:
        # 中间代码省略,具体见`data_save.py`
        ...

    @classmethod
    def get_origin_tb_info(cls) -> Union[list[tuple] , tuple[tuple, ...]]:
        '''
        类方法,返回原始数据表的信息
        '''
        if conn is None: # 如果没有生成数据库链接对象则生成
            conn = create_conn(db_type='pg')
        cur = conn.cursor()

        # 生成查询数据表信息的sql语句
        sql_info = f'''select column_name, udt_name from information_schema.columns
        where table_schema = '{cls.origin_sc}' and table_name = '{cls.origin_tb}' ''' # 可以看到,类方法可以调用类属性origin_tb

        with conn, cur:
            cur.execute(sql_info)
            res = cur.fetchall()

        return res

    @staticmethod
    def print_class_desc(): # 静态方法第一个参数不用填写cls/slef
        '''
        静态方法,打印这个类的功能
        '''

        print('TbInit是用于....')
我们可以按如下方式调用上述方法:
TbInit.print_class_desc() # 不用实例化直接调用静态方法
TbInit.get_origin_tb_info() # 不用实例化直接调用类方法
TbInit.origin_db # 不用实例化直接调用类属性
tb_init_ins = TbInit('ins_db', 'ins_sc','ins_tb') # 实例化
tb_init_ins.check_tb() # 实例化后调用实例方法
tb_init_ins.db # 实例化后调用实例属性
到这里,对于类的构成想必还有一些疑问:
- 定义实例方法和类方法时,参数
self,cls是什么东西 self,cls有什么区别- 为什么静态方法不用这些参数
- 为什么要分实例方法/属性,类方法/属性,静态方法
self/cls 是什么 #
- 感性的理解:是用于"绑定“各属性、方法的对象(确切地说是指针[1])
“绑定” 也对应了之前提到类可以 “集成” 各种方法的特性,self和cls绑定的是不同的对象(后文会详细解释) - 绑定后,这些方法和属性可以在类内部成员共享(绑定在同一个对象上的,可以互相引用)
由于self,cls绑定对象不同,能够引用的范围也不同 - 需要
self,cls是因为在定义类的过程中,方法和属性绑定的对象还不存在(因为还在定义阶段,没有完成)self,cls相当于一个 “替代品”,替代了(指向)这个目前还不存在的"类/类实例”,方法/属性先绑定在这个"替代品"上
当类定义结束/类实例化后,我们可以通过这个"替代品",找到我们定义的类/类的实例,调用相应的函数
对于"绑定"和"共享"这两个关键词,我们同样用TbInit举例:
class TbInit:
    '''
    该类用于准备数据储存的数据表
    '''

    def __init__(self, db: str = INSERT_DB, sc: str = INSERT_SC, tb: str = INSERT_TB):
        self.db = db # 绑定在self上的属性
        ...

    def check_tb(self, conn: connection = None) -> bool:
        self.drop_tb() # 改写check_tb用来演示"绑定"和"共享"
        self.db

    def drop_tb(self, conn: connection = None):
        ...

    def create_tb(self, conn: connection = None):
        ...

    ...
可以看到由于 check_tb 绑定到了 self 上,那么在 check_tb 内部就可以引用其他绑定在 self 上的方法 drop_tb 和属性 db。
self/cls 区别 #
首先需要说明,self,cls是我们约定俗成的写法,理论上写成其他形式都可以。
二者的区别是由classmethod装饰器引起的,具体的区别如下
- 绑定对象不一样
self绑定的是实例对象;cls绑定对象是类
类和对象的关系,参照上文,可回忆手机\sim卡的例子 - 因为绑定对象不一样,可引用方法/属性范围不一样
实例方法可以通过self同时引用实例方法、实例属性、类方法、类属性
类方法只能通过 cls 引用类方法、类属性,不能引用实例方法、实例属性
特殊的静态方法 #
静态方法和实例/类方法不同,她没有"绑定"对象而只是集成在类里,以TbInit.print_class_desc为例
    @staticmethod
    def print_class_desc(): # 静态方法第一个参数不用填写cls/slef
        '''
        静态方法,打印这个类的功能
        '''
                TbInit.class_attraibute # 通过类本身访问类属性
                TbInit.class_method() # 通过类本身访问类方法

        print('TbInit是用于....')
因此静态方法具有以下特点
- 无法引用实例的方法或者属性 (因为没有绑定类/实例对象)
- 由于没有绑定对象,只是集成在类里,所以通过类本身来引用类方法/属性
- 实例/类方法可以通过指针(self,cls)来访问静态方法
- 无需实例化直接调用
TbInit.print_class_desc()
为什么这么设计 #
为什么类要设计这么多不同的方法,不统一用实例方法?
这是因为用途不一样(严谨地说是抽象的层次不一样),还是以 TbInit 为例:
静态方法
print_class_desc, 打印类的功能介绍
- 只是集成在类里(没有任何绑定对象),方便维护复用
- 不受实例化,也就是具体对象的属性的影响 (无论类的属性,实例属性怎么变都不影响静态方法功能)
可以不实例化就使用, 但不能引用类属性/实例属性
类方法
get_origin_tb_info: 获取存储原始数据的数据表信息
- 绑定对象是类,不受实例化影响,可以使用类属性,可以不实例化就使用,这点和静态方法类似
- 受类状态影响,类属性/其他类方法修改了,其功能有可能会随之改变
例如get_origin_tb_info调用了类属性origin_tb等,如果类属性变动,其结果有可能也会变动 - 不可以使用实例方法或实例属性,例如
cls.check_tb(),cls.db - 可以同时被类对象指针cls和实例对象指针self调用,这和静态方法就不同了
- 如果希望方法的状态和类保持一致,可以调用类属性/其他类方法且不受实例化影响,将它写成类方法;否则可以写成静态方法
实例方法
check_tb: 检查数据库表是否满足要求
- (指针)绑定对象是实例,需要实例化后使用,受到具体对象的特殊属性影响
具体到TbInit,每次实例化的数据库表是不同的tb_init_ins = TbInit(self.db, self.sc, self.tb) - 引用范围最广,可以同时引用类和实例的属性及方法
- 如果方法和类使用情况(实例的状态)相关,方法的结果会受实例状态影响,且实例化的状态会在方法内部共享(实例属性),写成实例方法
例如TbInit作为一个类可能被复用,内部的三个方法check_tb,drop_tb,create_tb
每次检查的表都会不同但三个方法引用的实例属性是统一的self.tb等,在三个方法间共享,所以写成实例方法
最后我们还要了解类的特性以及其带来的优势
类的特性 #
- 封装
- 继承
- 多态
封装 #
- 类作为对象行为的抽象和归纳,划定功能边界
就好像TbInit类就是用来准备数据表 - 隐藏内部细节,暴露特定的接口,规定与其他模块交互的方式;
调用TbInit的方法例如check_tb时,不需要了解方法内部的逻辑,只要了解该方法的输出是什么即可 - 封装做的好,类的行为边界越清晰,整个系统解耦做的越好,扩展性/鲁棒性越高
就好像DataMove.init_copy_tb引用了TbInit一样
class DataMove:

    ...

    def init_copy_tb(self):
        '''
        初始化用于储存迁移数据的表

        '''

        tb_init_ins = TbInit(self.db, self.sc, self.tb) # 实例化,为后续使用"准备数据表"功能做准备
        is_tb_ready = tb_init_ins.check_tb() # 检查迁移表是否满足要求
        if not is_tb_ready: # 不满足
            tb_init_ins.drop_tb() # 删除迁移表
            tb_init_ins.create_tb() # 按要求创建迁移表
    ...
可以看到,无论 TbInit 内部的方法如何改动,只要保证其方法的输出类型一致,DataMove.init_copy_tb 是不需要作任何修改的
继承/多态 #
继承和多态要放在一起说,多态某种程度上讲是继承的结果
什么是继承/多态
# 继续用食物的例子(代码形式)解释什么是继承/多态

class StuffedDough:
    '''
    一个塞着馅料的面团罢了
    '''

    ingredient_type = '有机物' # 类属性

    def __init__(self, dough: str, stuffing: str): # 实例化方法
        '''
        实例化,获取面团和馅料的具体材料
        '''
        self.dough = dough # 实例属性
        self.stuffing = stuffing

    def cook(self): # 有一个烹饪方法
        ...

    def shape(self): # 有一个塑形方法
        print('面团包着馅料罢了')
class SteamBun(StuffedDough): # 继承
    '''
    包子
    '''

    def cook(self): # 重写方法
        print('蒸')

    # def shape(self):
    #     print(f'我已经是{self.stuffing}包子的形状了')

    def dip(self): # 新增方法
        print(f'沾点醋')


class Tortellini(StuffedDough):
    '''
    意式饺子
    '''

    def cook(self): # 重写且和包子不一样,是为"多态"
        print('煮')

    def shape(self):
        print(f'我已经是{self.stuffing}意式饺子的形状了')
pork_bun = SteamBun('低筋小麦面粉', '猪肉') # 猪肉包子
pork_bun.shape()
pork_bun.dip()

rice_bun = SteamBun('低筋小麦面粉', '大米') # 警示我们,类实例化可供定制的内容需视情况而定
rice_bun.shape() # 当然,如果接受一个大米馅的包子也行。。。
为什么继承/多态
继承
- 是为代码复用和设计复用而设计的,提高编程效率,即继承一个类时,我们可以获得原类的全部方法和属性。
- 修改类方法时,不影响调用了父类的代码。
多态
- 子类和父类或者其他子类之间, 同一个方法有不同的特性
- 是继承重写方法/属性导致的结果
还是以TbInit为例,它在多处被引用,例如在同一文件内的DataMove引用:
class DataMove:

    ...
    def init_copy_tb(self):
        '''
        初始化用于储存迁移数据的表

        '''
        tb_init_ins = TbInit(self.db, self.sc, self.tb) # 实例化,为后续使用"准备数据表"功能做准备
        is_tb_ready = tb_init_ins.check_tb() # 检查迁移表是否满足要求
        if not is_tb_ready: # 不满足
            tb_init_ins.drop_tb() # 删除迁移表
            tb_init_ins.create_tb() # 按要求创建迁移表
也在不同文件main.py中引用:
...
from data_save_with_class import DataMove, DataSave, TbInit

...
# 数据更新/插入
uni_key = ['id', 'time'] # 数据的唯一键,具体按实际情况构造,例如通过用户id和行为类型构建数据id间
data_sv_ins = DataSave(uni_key)
exist_uni_key = data_sv_ins.get_old_data(data_final) # 查看哪些数据是已经存在,稍后进行更新
data_to_update, data_to_insert = data_sv_ins.split_update_insert_data(data_final, exist_uni_key) # 将数据分为用于插入的和更新的
data_sv_ins.update_data(data_to_update) # 更新数据
data_sv_ins.insert_data(data_to_insert) # 插入数据
现在我们复用TbInit的大部分功能的同时,对已有的方法做微调
但TbInit已经被多出引用,不希望这种变动会影响到已经引用了TbInit的代码,我们可以用类继承来解决
class SubTbInit(TbInit): # 继承TbInit

    def check_tb(self): # 改写check_tb
        ... # 改写的逻辑

sub_init_ins = SubTbInit(...) # 使用SubTbInit
这样子复用了 TbInit 的大部分功能,改写了 check_tb 的逻辑,且没有影响到已经引用了 TbInit 的代码。
Related readings
- Writing Maintainable Code
- Building a Project Structure
- Overview of the AI Development Software Environment
- Image Classification and Foundational Vision Models
If you want to follow my updates, or have a coffee chat with me, feel free to connect with me: