CUDA Programming Model
July 28, 2023 · 11 min read
If you have any questions, feel free to comment below. Click the block can copy the code.
And if you think it's helpful to you, just click on the ads which can support this site. Thanks!
梳理 CUDA 异构计算、执行空间说明符、线程层次、NVCC 编译流程和 NVProf 性能分析。
异构计算 #
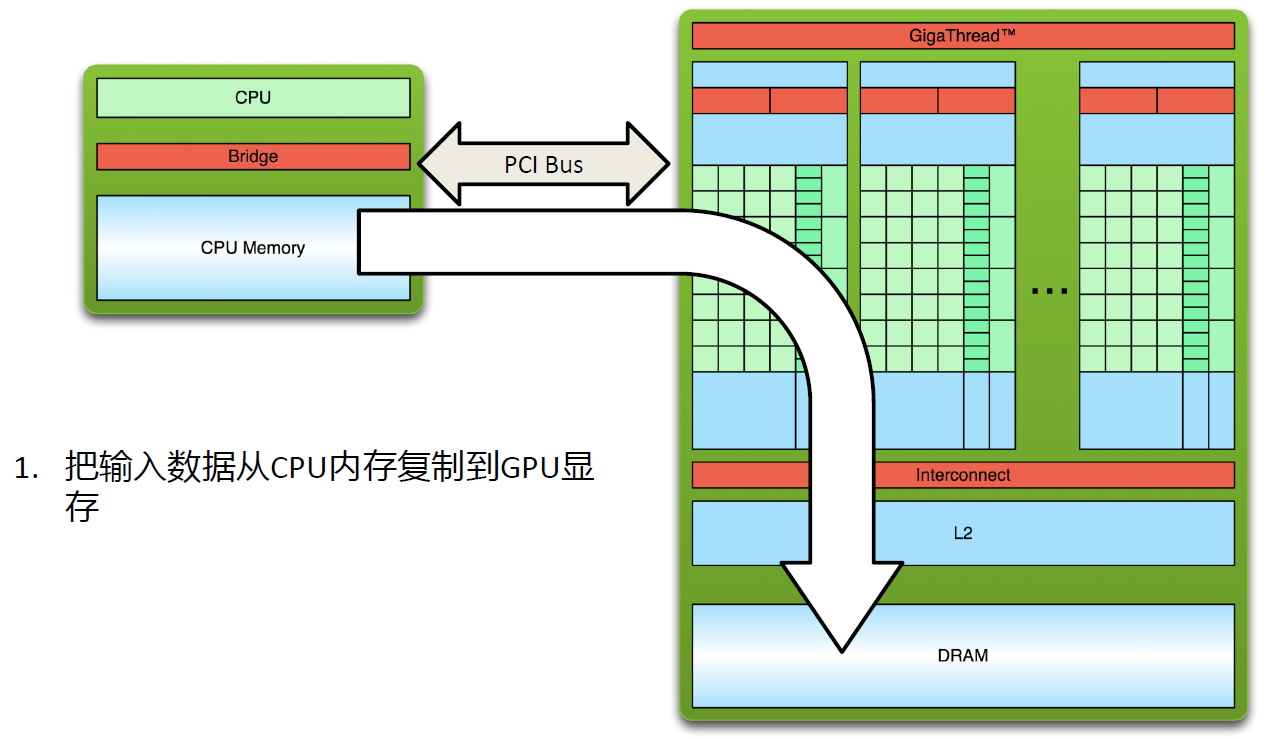
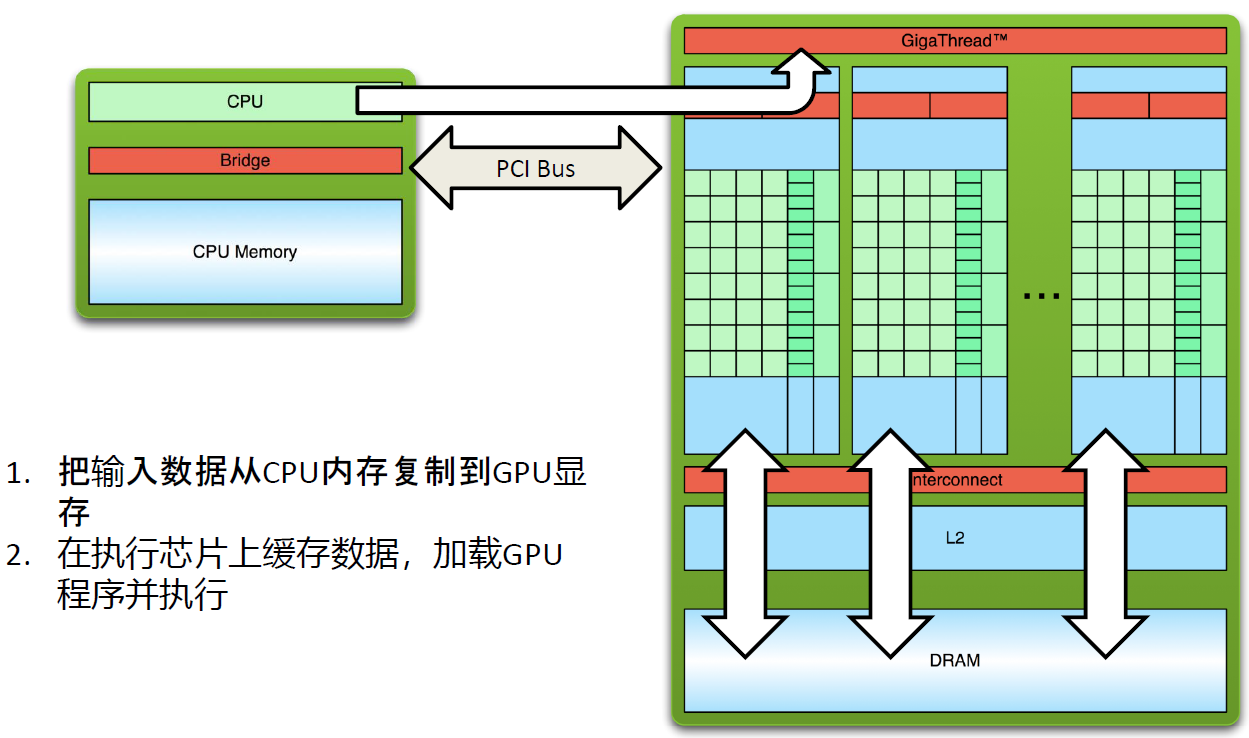
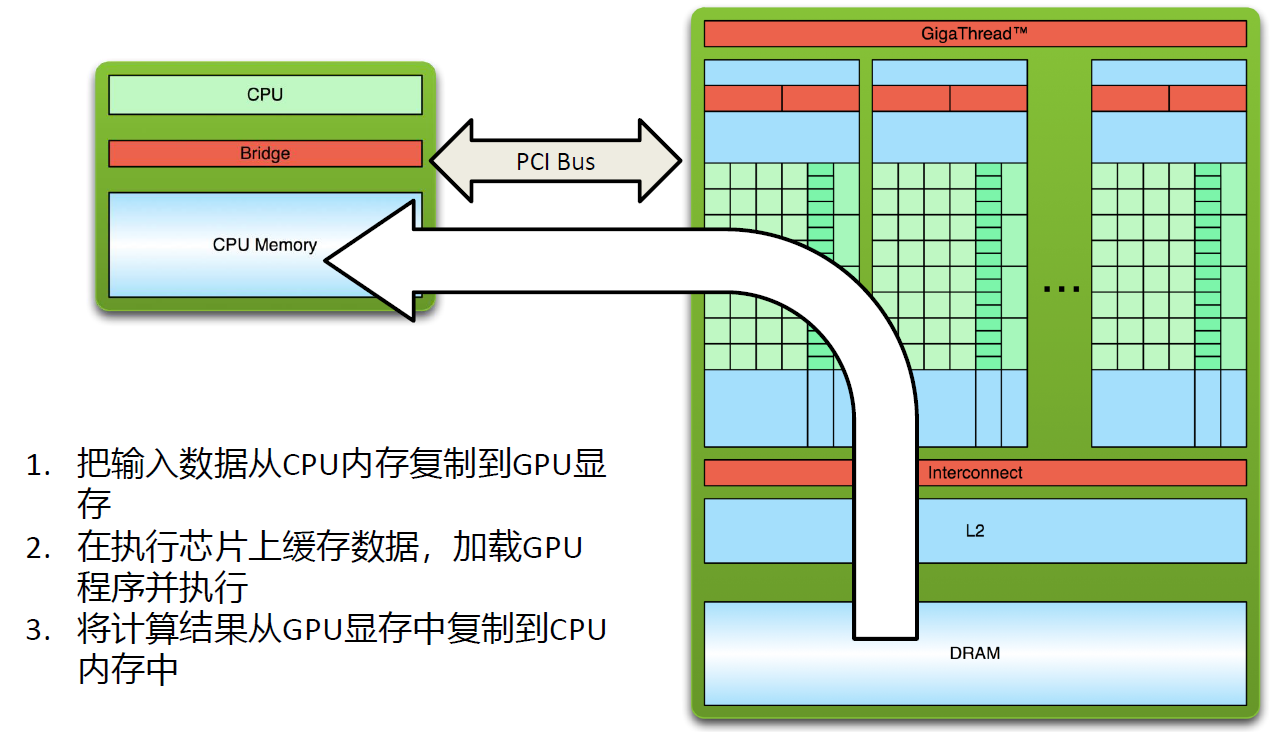
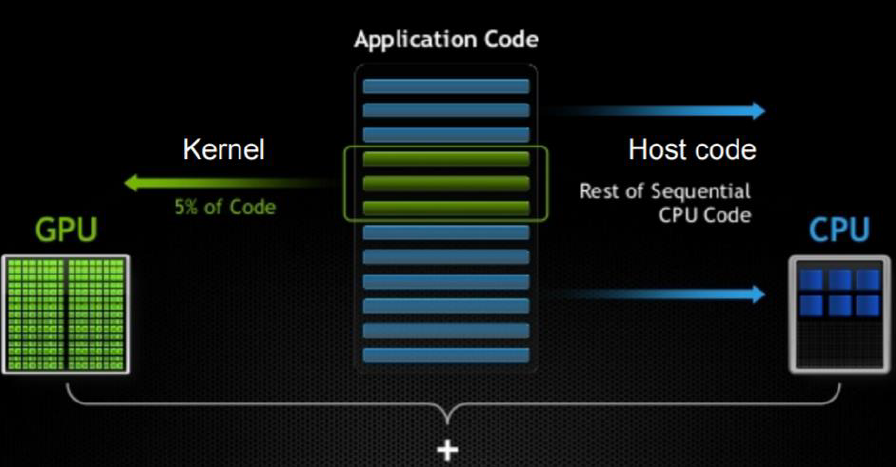 异构计算是把整个的一个计算任务,将一部分放在 gpu 里运行,将另一部分放到 CPU 里边。当中说计算密集性的任务,比如单一指令或小指令的大数据,它虽然代码不太多,但是需要计算它的地方非常多,把这些任务放在 gpu 当中去执行。
术语介绍 #
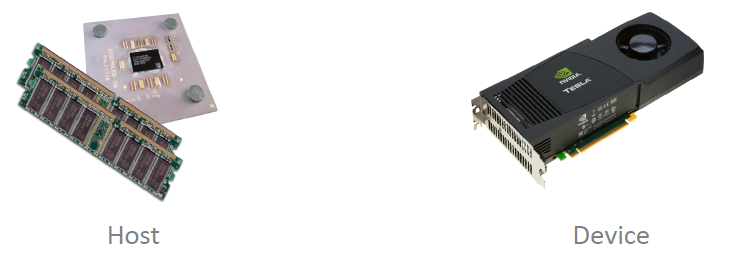
Host:CPU 和内存 (host memory)
Device:GPU 和显存 (device memory)
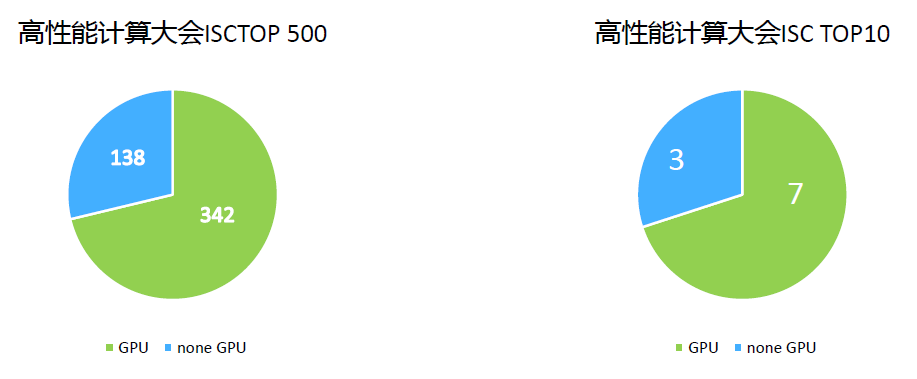
异构计算流行 #
CUDA 安装 #
适用设备:所有包含 NVIDIA GPU 的服务器,工作站,个人电脑,嵌入式设备等电子设备。
软件安装
- Windows: https://docs.nvidia.com/cuda/cuda-installation-guide-microsoft-windows/index.html[1] 只需安装一个.exe 的可执行程序
- Linux: https://docs.nvidia.com/cuda/cuda-installation-guide-linux/index.html[2] 按照上面的教程,需要6 / 7 个步骤即可
- Jetson: https://developer.nvidia.com/embedded/jetpack[3] 直接利用 NVIDIA SDK Manager 或者 SD image 进行刷机即可
查看当前设备中GPU 状态:
- 服务器,工作站,个人电脑:nvidia-smi
- Jetson 等设备: Jtop
其他工具:
- 查看当前设备参数:在 CUDA sample 中 1_Utilities/ deviceQuery 文件夹下的 deviceQuery 程序。以 Ubuntu 为例, deviceQuery 程序在 /usr/local/cuda/samples/1_Utilities/deviceQuery https://github.com/NVIDIA/cuda-samples[4] 编译运行 deviceQuery 程序即可。
CUDA 程序的编写 #
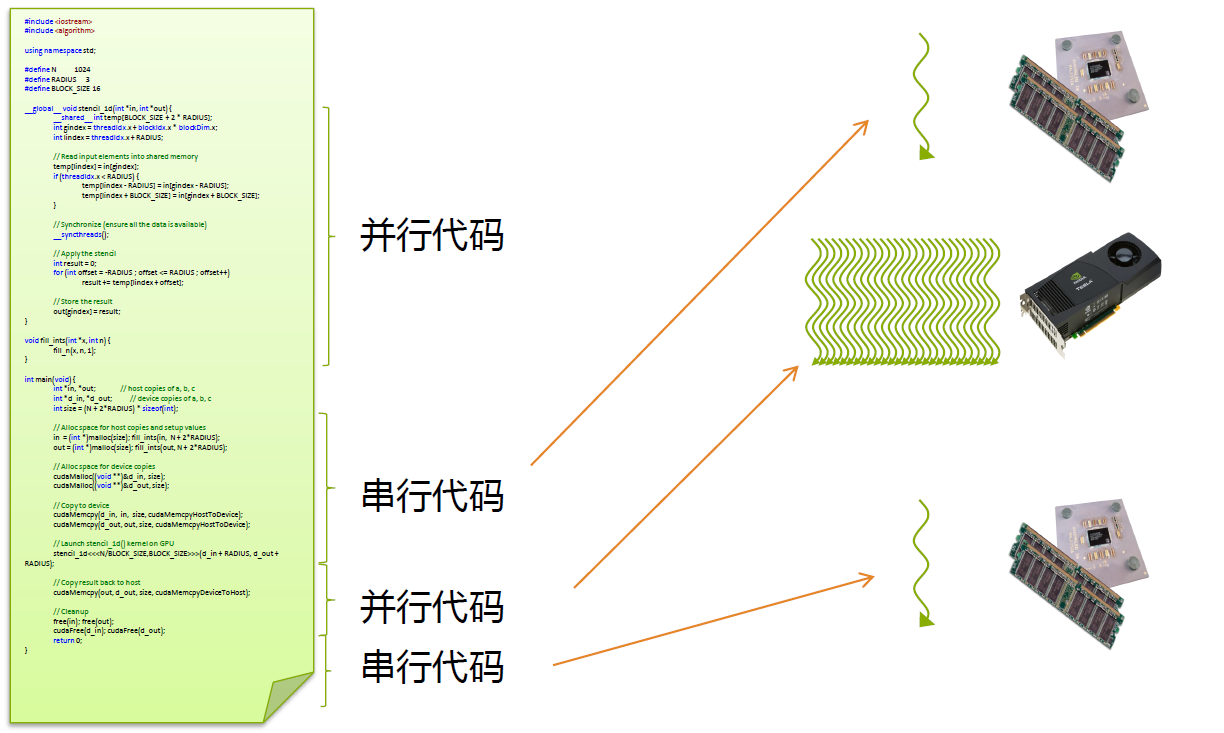
将 gpu 代码和 CPU 代码写在一起,这里写的串行代码就是 CPU 代码,并行代码也就是 gpu 代码。后期可以通过编译器将 GPU 和 CPU 分别编译好之后,再组合成一个执行程序
总体流程 #
CUDA编程模式 Extended C #
__global__ #
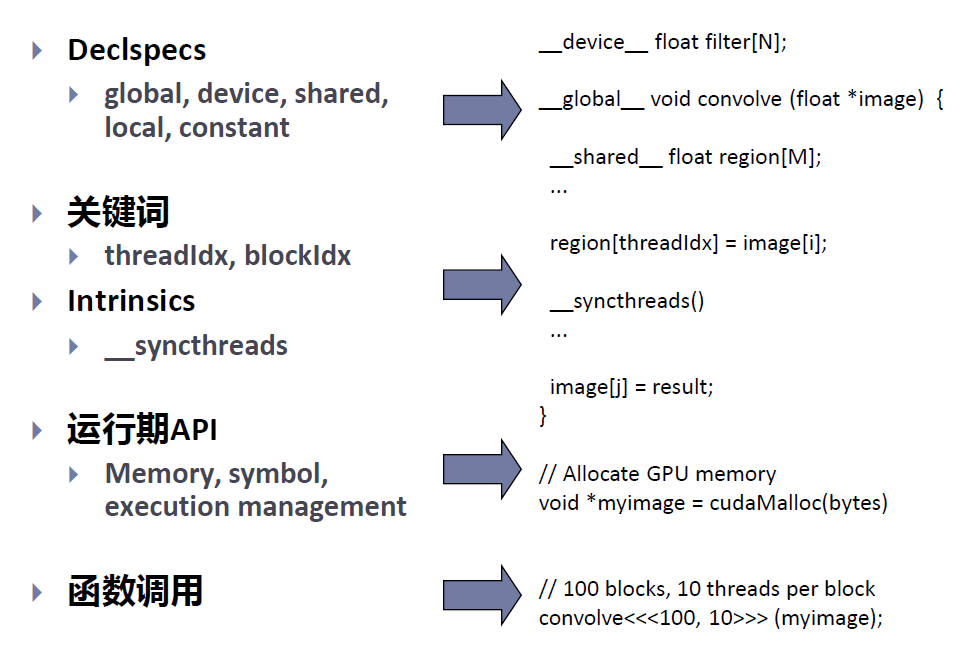
__global__执行空间说明符将函数声明为内核。它的功能是:
- 在设备上执行,
- 可从主机调用,可在计算能力为 3.2 或更高的设备调用。
__global__函数必须具有 void 返回类型,并且不能是类的成员。- 对
__global__函数的任何调用都必须指定其执行配置。 - 对
__global__函数的调用是异步的,这意味着它在设备完成执行之前返回。
__device__ #
__device__执行空间说明符声明了一个函数:
- 在设备上执行
- 只能从设备调用
__global__和__device__执行空间说明符不能一起使用。
__host__ #
__host__执行空间说明符声明了一个函数:
- 在主机上执行
- 只能从主机调用
__global__和__host__执行空间说明符不能一起使用。但是,__device__和__host__执行空间说明符可以一起使用,在这种情况下,该函数是为主机和设备编译的。
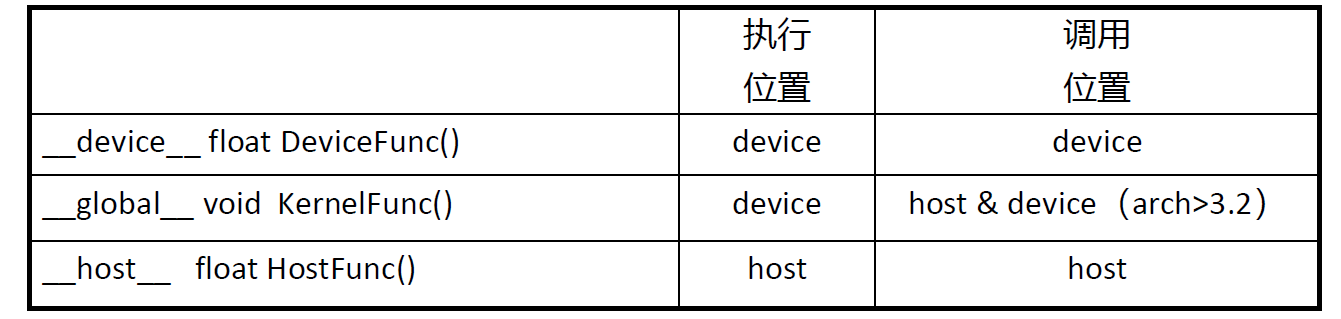
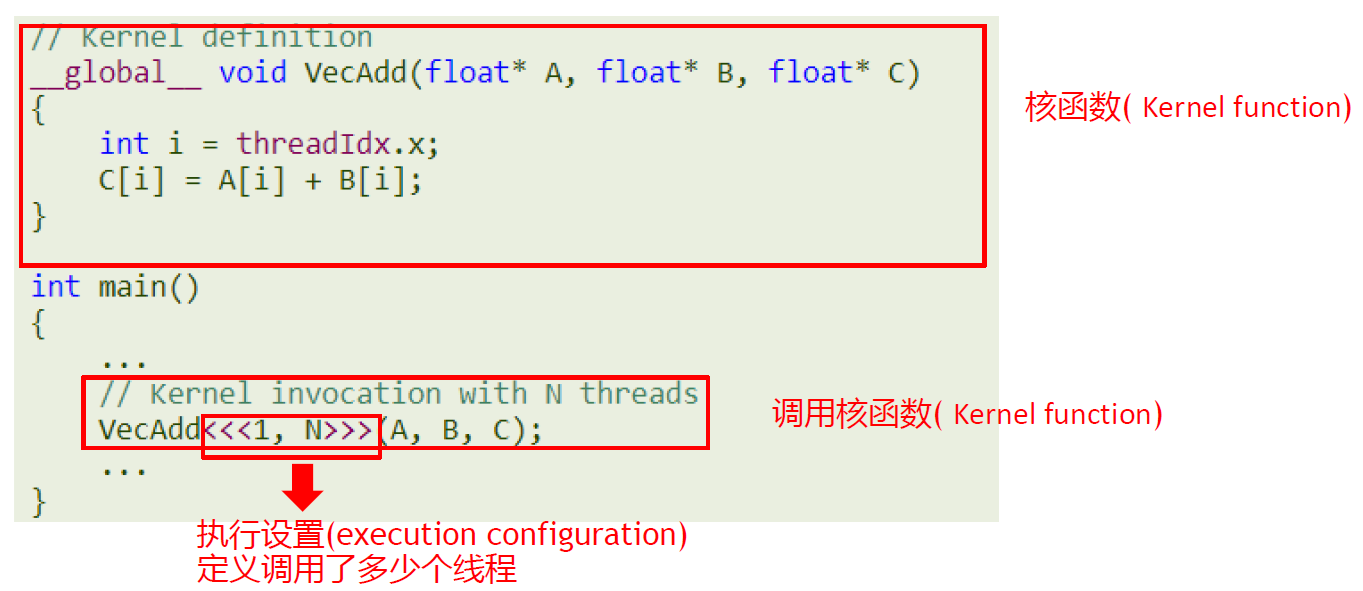
__global__定义一个 kernel 函数- 入口函数,CPU 上调用, GPU 上执行
- 必须返回 void
__device__and__host__可以同时使用- 如果什么都不加,则默认是一个
__host__函数。
CUDA 线程层次 #
HelloFromGPU <<<grid_size, block_size>>>();
Thread: sequential execution unit
- 所有线程执行相同的核函数
- 并行执行 Thread Block: a group of threads
- 例如 10 个 Thread 组成一个 Block
- 执行在一个 Streaming Multiprocessor (SM)
- 同一个 Block 中的线程可以协作(当然一个 SM 中可能会执行多个 Block,例如有些 Block 是在计算的,有的实在等待的) Thread Grid : a collection of thread blocks
- 一个 Grid 中包含多个 Blcok
- 一个 Grid 当中的 Block 可以在多个 SM 中执行
- 一个 Grid 中的定义是针对与整个设备的
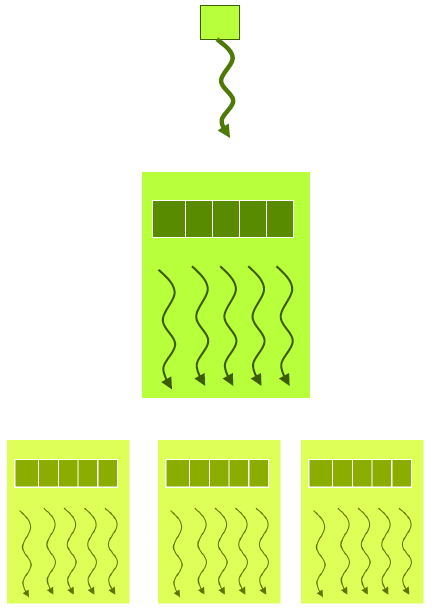
因此上面的 grid_size 指包含多少个 Block,而 block_size 指一个 Block 中包含多少个 Thread。
执行设置 #
dim3 grid (3,2,1), block (5,3,1) 共有三个维度
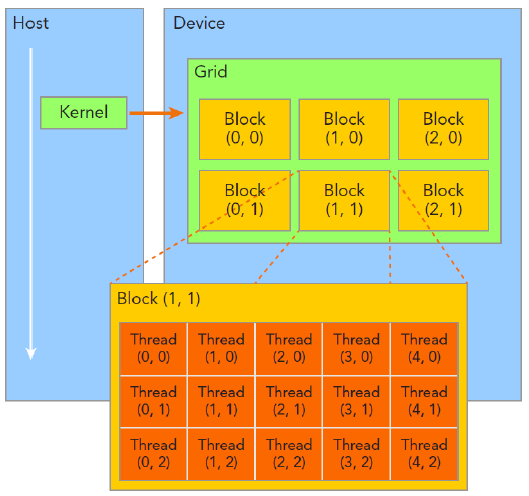 Built-in variables:
threadldx.[x y z]是执行当前kernel函数的线程在block中的索引值
blockldx.[x y z]是指执行当前kernel函数的线程所在block在grid中的索引值blockDim.[x y z]表示一个 block 中包含多少个线程gridDim.[x y z]表示一个grid中包含多少个block
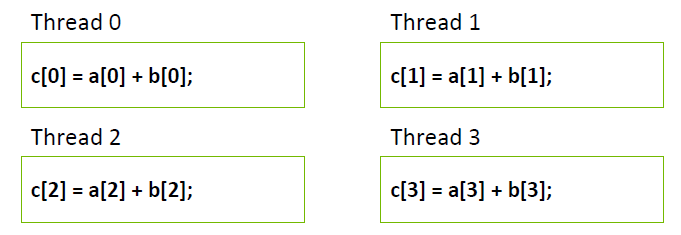
__global__ void add( int *a, int *b, int *c ) {
	c[threadIdx.x ] = threadIdx.x ] + threadIdx.x
}
add<<<1,4>>>( a, b, c);
上面程序实际上在设备上运行的样子:
对应关系 #
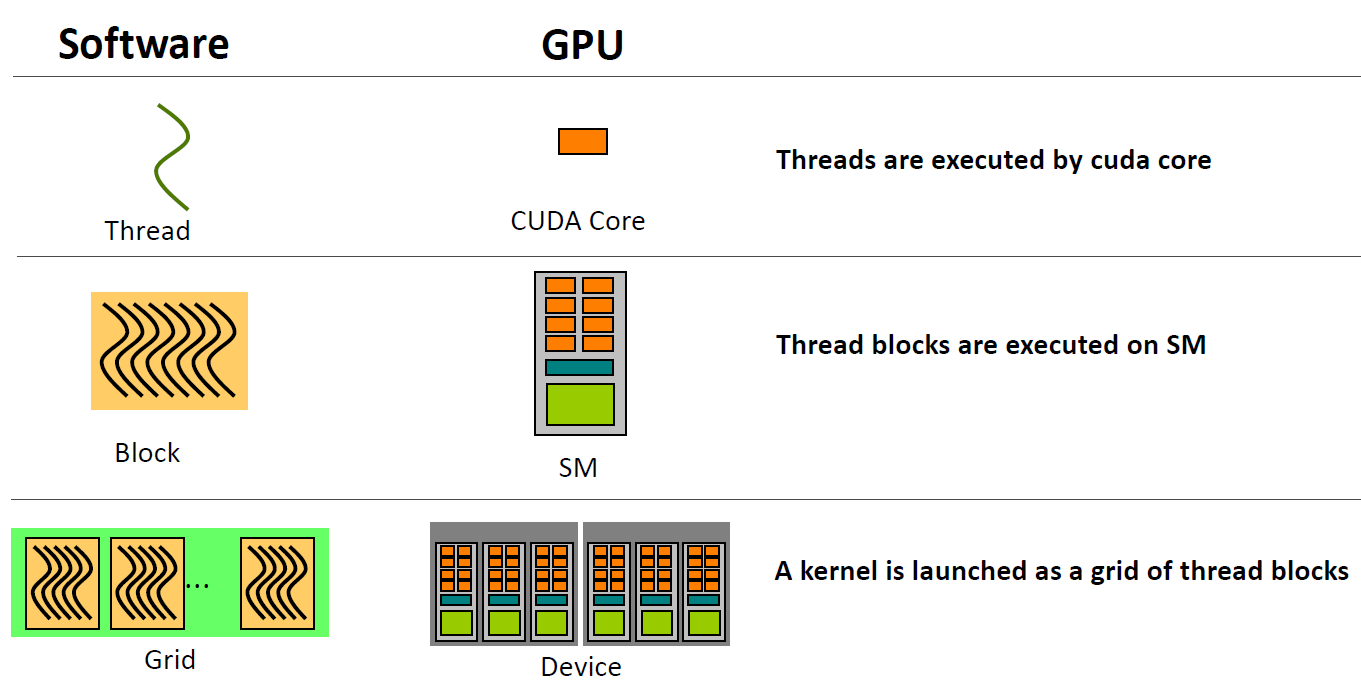 如上,Thread 执行在 GPU 的 CUDA 核中,Block 执行在 SM 中,Grid 执行在设备层面。但是反过来说就不对了,例如 CUDA 核不止执行这一个 Thread,因为一个 Thread 在执行过程中可能产生分支,可能产生等待,可能加载数据,加载 memory 当中一些读取,读写等一些操作,那这个时候呢,CUDA 核可能去执行别的。
为什么不是只有线程?这样我们不就可以使用的更方便了吗? Blocks 好像也不是必须的
- 增加了一个层级的抽象,也增加了复杂度
- 使用 Blocks 或者 Grid 我们收获了什么? 答:
- 有些时候线程之间需要协作,例如并行线程执行(Parallel Thread eXecution,PTX)代码是编译后的 GPU 代码的一种中间形式。这时 Block 就充当一个 cooperrative thread arrays (CTA),在执行的时候,如果一个 Block 没有执行完成,则可以执行其他不相关的 Block,不必同步所有的数据。
- 同时,区分 Block 可以将多个指令限定在一个小范围内,这样多个 Block 之间可以产生多种的协作方式。
- 区分 Block 可以便于扩展,只需要增加一个个 SM,早期的代码也可以获得高效的加速。同时,如果没有 Block 结构,所有线程共享全部,那么随着处理器数量的增加,协作读写 memory 需要带宽,这也会限制加速效果。
CUDA 程序编译 #
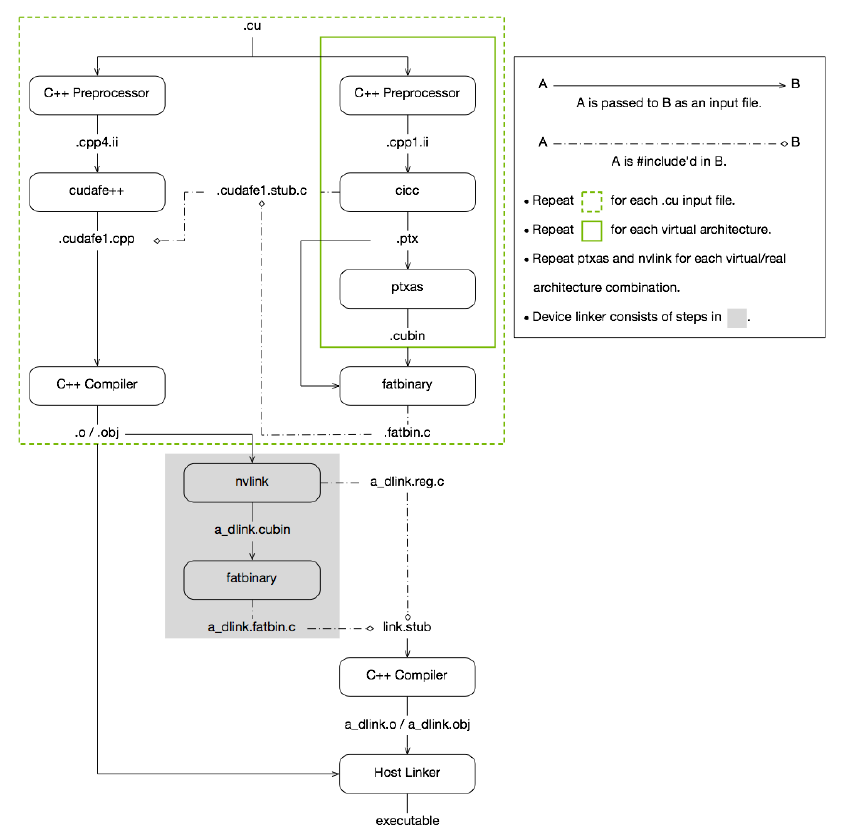
可见,CUDA 文件以.cu 结尾,用 CUDA 提供的nvcc工具进行编译。 为了兼容不同GPU架构,CUDA采用了虚拟计算架构和真实SM架构两段式的编译方法。
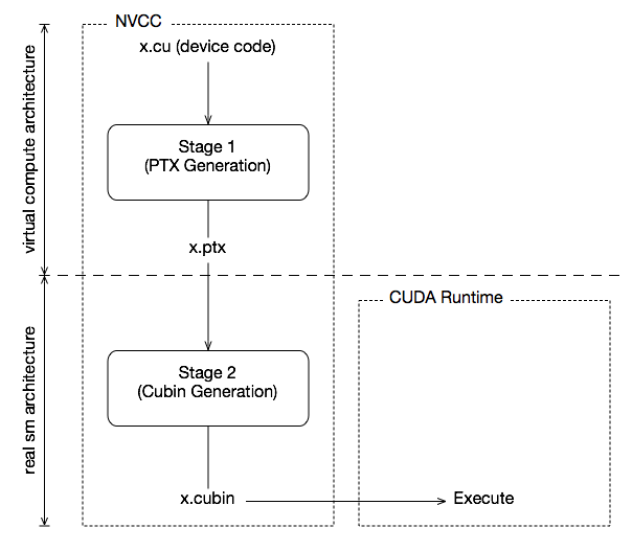
https://docs.nvidia.com/cuda/cuda-compiler-driver-nvcc/index.html[5]
在编译时要根据 GPU 架构选择合适的计算能力(Compute Capability),需要注意的是,虚拟计算架构的计算能力不能大于真实 SM 架构,如下图,sm_xx 表示真实 SM 架构,compute_xx 表示虚拟架构。
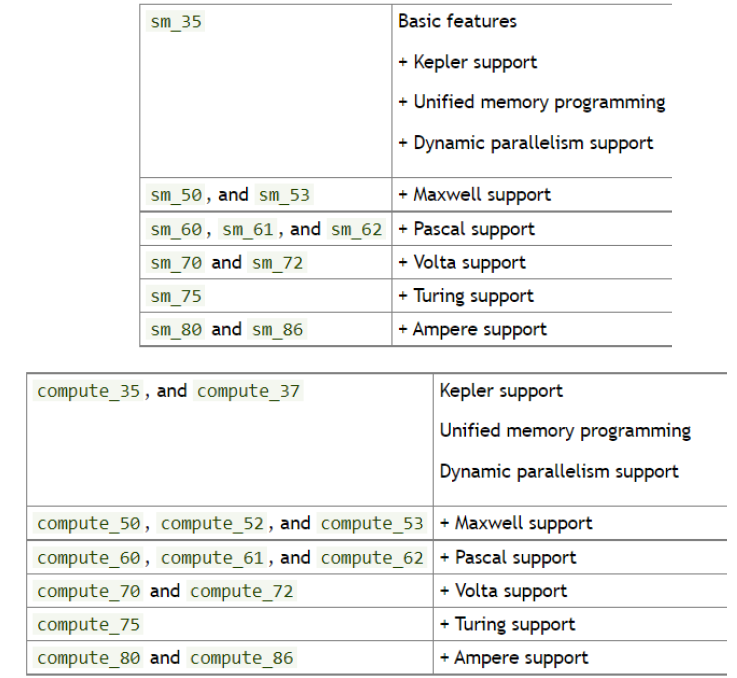
可以采用以下几种方式进行编译:
//code 为真实架构,arch为虚拟架构,要保证arch <= code
nvcc x.cu --gpu-architecture=compute_50 --gpu-code=sm_50,sm_52
nvcc x.cu \
  --generate-code arch=compute_50,code=sm_50\
  --generate-code arch=compute_50,code=sm_52\
  --generate-code arch=compute_50,code=sm_53\
关于每个 Compute Capability 对应的特性和硬件性能可以查下表:
https://docs.nvidia.com/cuda/cuda-c-programming-guide/index.html#features-and-technical-specifications-technical-specifications-per-compute-capability[6]
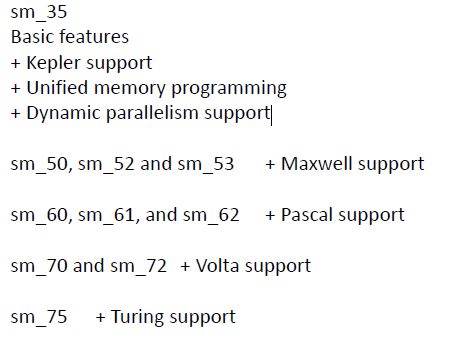
真实 SM 架构的版本差异 #
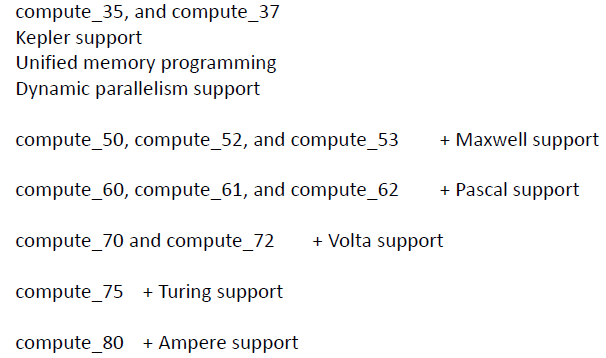
虚拟架构的版本差异 #
编译过程 #
nvcc --gpu-architecture=sm_50 --device-c a.cu b.cu
nvcc --gpu-architecture=sm_50 a.o b.o -o a.exe
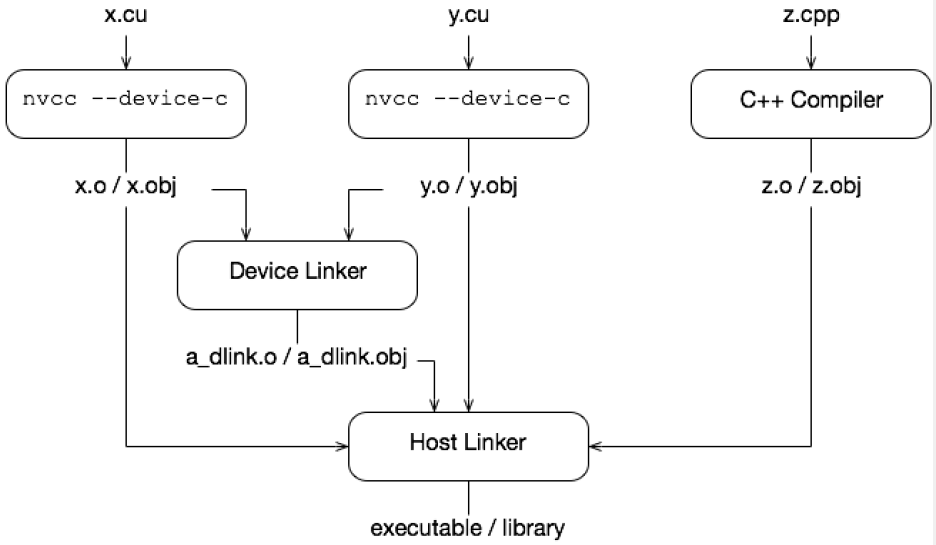
nvcc --device-c hello_from_gpu.cu -o hello_from_gpu.o
nvcc hello_from_gpu.o hello_cuda_main.cu -o hello_from_gpu
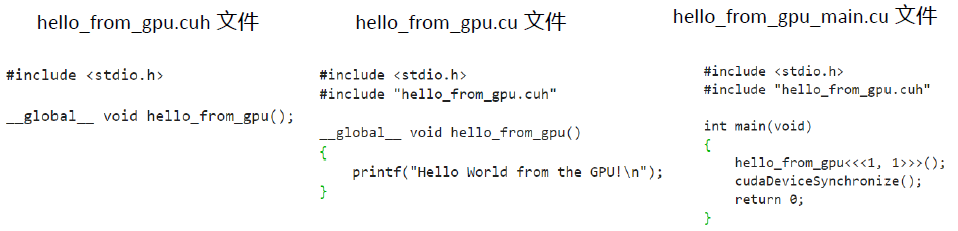
.cuh 文件类似于 C/C++中的.h 头文件,你可以将核函数写在里面,然后在 .cu 文件中包含该 .cuh 文件后就可以调用核函数了。
nvcc --device-c hello_from_gpu.cu -o hello_from _gpu.o
nvcc hello_from_gpu.o hello_cuda_main.cu -o hello_from_gpu
利用 NVProf 查看程序执行情况 #
Kernel Timeline 输出的是以 gpu kernel 为单位的一段时间 的运行时间线,我们可以通过它观察 GPU 在什么时候有 闲置或者利用不够充分的行为,更准确地定位优化问题。 Nvprof 是 nvidia 提供的用于生成 gpu timeline 的工具,其为 Cuda toolkit 的自带工具。
nvprof -o out.nvvp a.exe
可以结合 Nvvp 或者 nsight 进行可视化分析 https://docs.nvidia.com/cuda/profiler-users-guide/index.html#nvprof-overview[7]
nvprof a.exe
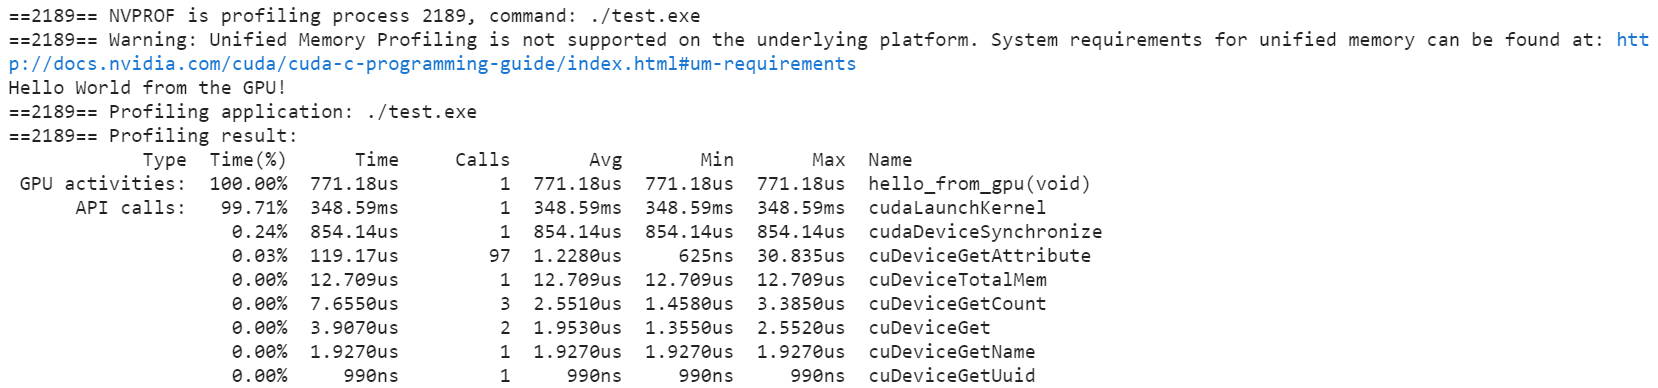
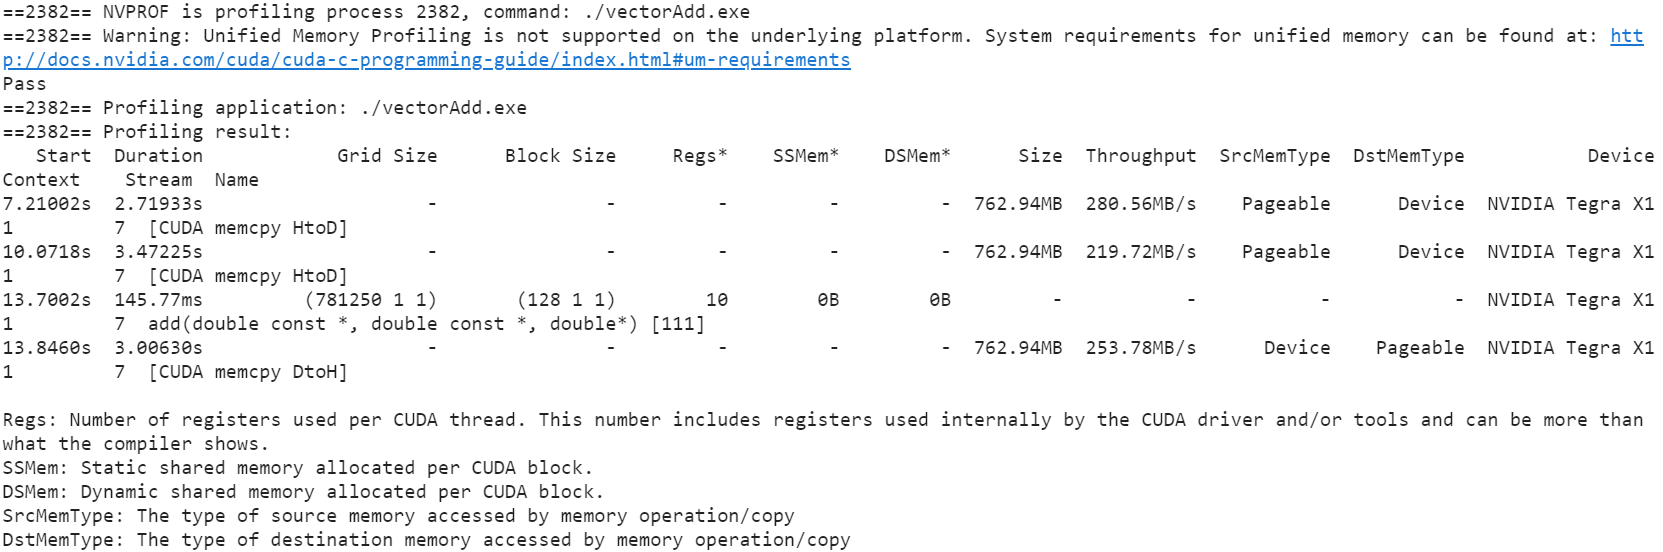
nvprof --print-gpu-trace a.exe
GPU-Trace 模式提供按时间顺序在 GPU 上发生的所有活动的时间线。每个内核执行和内存复制/设置实例显示在输出中。对于每个内核或内存副本,都会显示内核参数、共享内存使用情况和内存传输吞吐量等详细信息。内核名称后面方括号中显示的数字与 CUDA API 相关启动该内核。
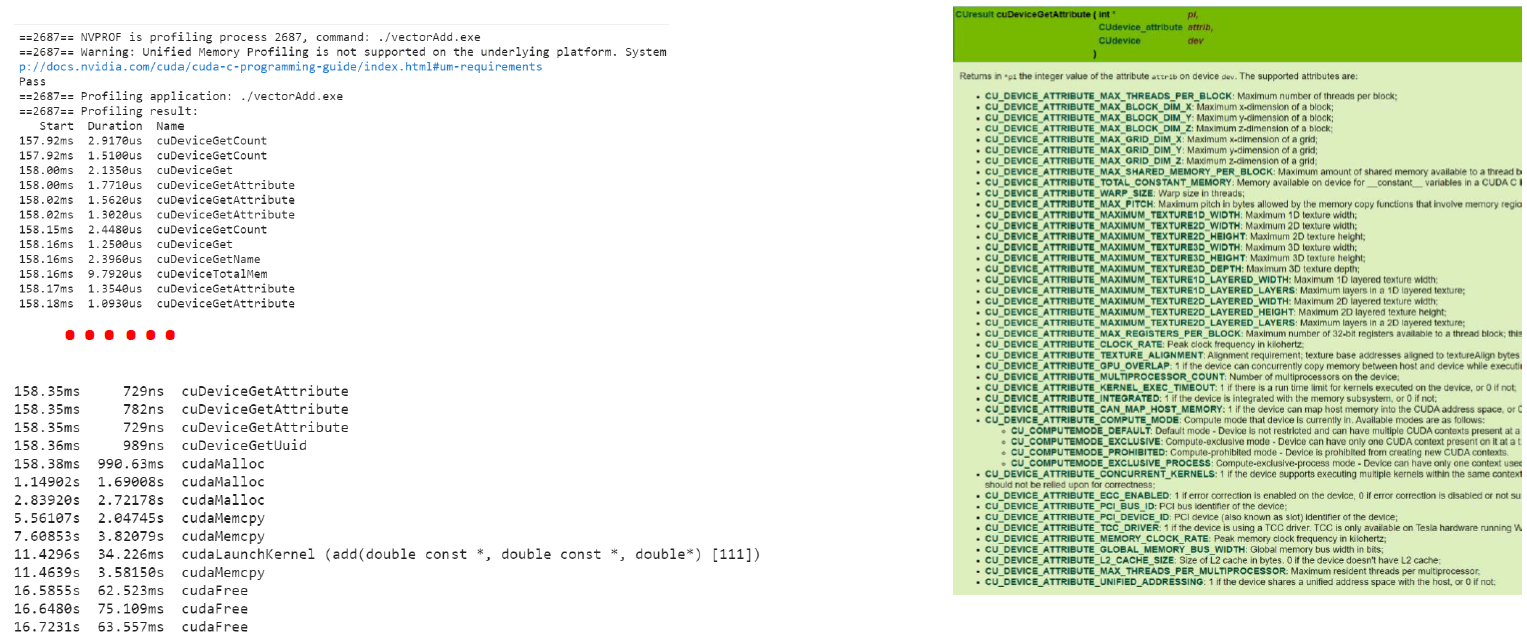
nvprof --print-api-trace a.exe
API 跟踪模式显示主机上调用的所有 CUDA 运行时和驱动程序 API 调用的时间线。
相关参考: https://docs.nvidia.com/cuda/pdf/CUDA_Profiler_Users_Guide.pdf[8]
References
- https://docs.nvidia.com/cuda/cuda-installation-guide-microsoft-windows/index.html ↩︎
- https://docs.nvidia.com/cuda/cuda-installation-guide-linux/index.html ↩︎
- https://developer.nvidia.com/embedded/jetpack ↩︎
- https://github.com/NVIDIA/cuda-samples ↩︎
- https://docs.nvidia.com/cuda/cuda-compiler-driver-nvcc/index.html ↩︎
- https://docs.nvidia.com/cuda/cuda-c-programming-guide/index.html#features-and-technical-specifications-technical-specifications-per-compute-capability ↩︎
- https://docs.nvidia.com/cuda/profiler-users-guide/index.html#nvprof-overview ↩︎
- https://docs.nvidia.com/cuda/pdf/CUDA_Profiler_Users_Guide.pdf ↩︎
Related readings
- GPU Hardware Architecture
- Introduction to CUDA and Linux Basics
- Introduction to CUDA
- AI开发硬件环境综述
- Overview of the AI Development Software Environment
If you want to follow my updates, or have a coffee chat with me, feel free to connect with me: